Knight Cat AI Videoprompts: Eine Struktur, die funktioniert
 Knight Cat AI Team
Knight Cat AI Videoprompts brauchen fünf geordnete Slots: Motiv, Garderobe, eine Aktion, Kamera und Licht. Struktur zuerst, Adjektive zuletzt, jeweils eine Einstellung.
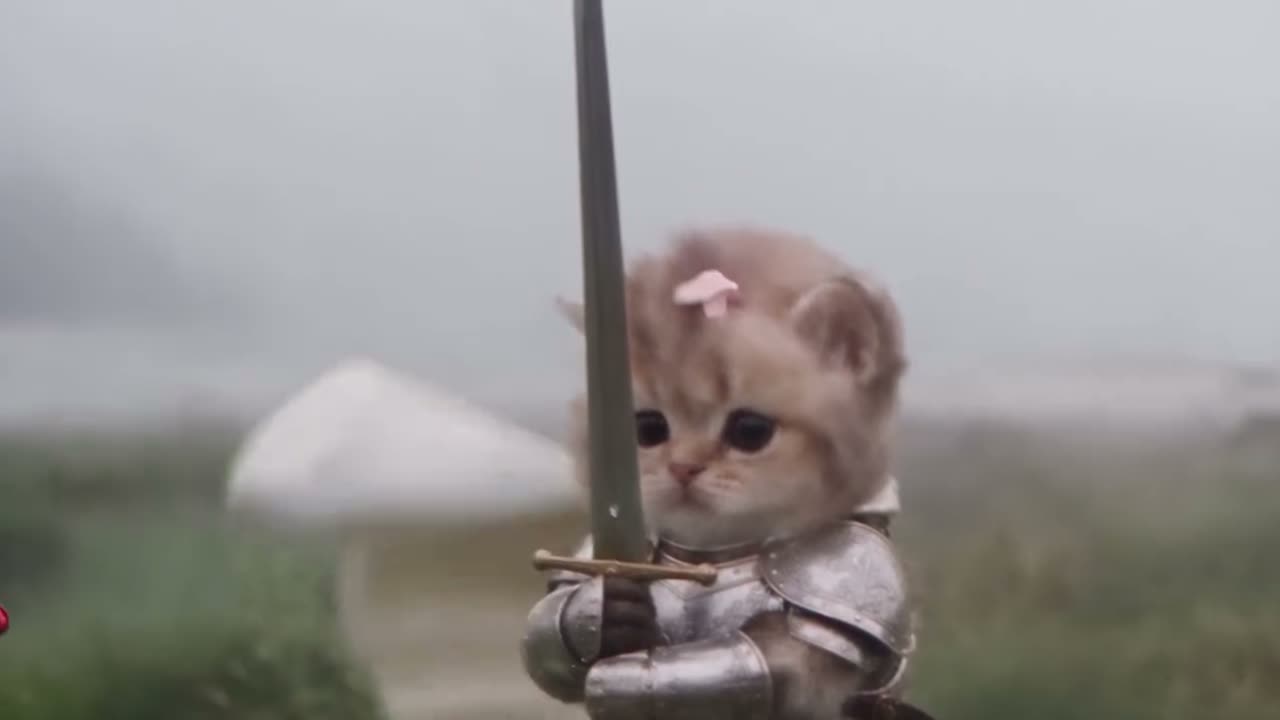
Ein guter Knight Cat AI Video-Prompt füllt fünf Slots in einer festen Reihenfolge: Subjekt, Garderobe, eine Aktion, Kamera, Licht. Alles andere, was du hinzufügen möchtest, ist Dekoration, und Dekoration ist der Teil, der ein 10-second-Rendering verschmieren lässt. Dieser Leitfaden behandelt die zwei Prompt-Pfade, die das Studio unterstützt, die Fragmentmuster, die standhalten, das Kamera-Vokabular, das tatsächlich die Ausgabe verändert, und die drei Fehlermodi, die für die meisten schlechten Renderings verantwortlich sind.
Die zwei Prompt-Pfade
Das Studio akzeptiert entweder ein Referenzfoto oder eine Textbeschreibung, und der Prompt, den du schreibst, verhält sich unterschiedlich, je nachdem, was du angibst.
Wenn du ein Foto hochlädst, muss dein Text-Prompt die Katze nicht beschreiben. Das Foto legt bereits Fellmuster, Gesichtsform, Ohrenposition und Markierungen durch Identitätsverankerung fest, also den Mechanismus, der dein Haustier erkennbar hält, während das Modell Garderobe und Umgebung austauscht. Deine Worte sollten stattdessen die Szene beschreiben, in die die Katze versetzt wird: was sie trägt, was sie tut, wo die Kamera steht und wie das Licht fällt.
Wenn du kein Foto angibst, muss der Prompt auch das Subjekt tragen. Das bedeutet, die Rasse-Silhouette, Fellfarbe und Muster sowie die Körperpose zu benennen, von der das Modell ausgehen soll. Text-zu-Video ist flexibler, weil nichts die Komposition einschränkt, und weniger nachsichtig, weil auch nichts die Identität verankert. Ein Prompt ohne Foto und ohne Fellbeschreibung erzeugt eine generische gepanzerte Katze, die deinem Haustier nur in der Art ähnelt.
Beginne auf dem Knight Cat AI Videogenerator, wenn du beide Eingaben nebeneinander sehen möchtest, bevor du etwas schreibst.
Die Fünf-Slot-Prompt-Struktur
Schreibe deinen Prompt als fünf kurze Phrasen in dieser Reihenfolge. Die Reihenfolge ist weniger wichtig als die Disziplin, jeden Slot genau einmal zu füllen.
- Subjekt — wer im Bild ist. Mit einem Referenzfoto ist das ein einzelnes Wort wie "die Katze in der Referenz". Ohne eines gib Fellfarbe, Muster und Statur an: "eine kleine graue Tabby mit weißen Socken und einem gekerbten linken Ohr".
- Garderobe — eine Rüstungsschicht und ein getragener Gegenstand, mehr nicht. "Gebürsteter Stahlbrustpanzer, Kettenhemdkragen, ein Kurzschwert in der rechten Pfote" ist vollständig. Ein Umhang, ein Helm, ein Schild und ein Banner hinzuzufügen gibt dem Modell fünf Objekte, die es in 10 Sekunden auflösen muss, und es wird einige weglassen oder verschmelzen.
- Eine Aktion — eine einzige dominante Bewegung für den gesamten Clip. "Tritt auf eine Steinstufe vor" ist eine Aufnahme. "Tritt vor, blickt auf, dann hebt das Schwert" sind drei Aufnahmen, in eine komprimiert, und das Ergebnis ist eine Verwischung.
- Kamera — wie sich der Bildausschnitt bewegt. "Statische Halbtotale" oder "langsamer Dolly-in auf die Pfoten". Eine Kameraanweisung pro Prompt.
- Licht — Tageszeit und Richtung. "Tiefes Dämmerungslicht von links, warmer Rand auf der Rüstungskante" schlägt "filmische Beleuchtung", die dem Modell nichts sagt, womit es arbeiten kann.
Ein so aufgebauter Prompt liest sich wie eine Shotlist statt wie ein Wunsch. Das ist der Punkt: Seedance 2.0 rendert, was es Bild für Bild auflösen kann, und jeder Slot, den du füllst, reduziert die Anzahl der Entscheidungen, die es erraten muss.
Dieser Clip: 30 Credits · 6 Clips pro Monat für $39.90 (Pro) oder 80 pro Jahr für $319
Starke Fragmente gegen schwache
Der Unterschied zwischen einem brauchbaren Prompt und einer verschwendeten Generierung ist meist eine oder zwei Wortwahlen. Die folgende Tabelle stellt Fragmente, die sauber aufgelöst werden, Fragmenten gegenüber, die es nicht werden.
| Slot | Schwaches Fragment | Starkes Fragment | | --------- | ------------------------ | ---------------------------------------------------- | | Subjekt | eine süße Katze | graue Tabby, weiße Socken, gekerbtes linkes Ohr | | Garderobe | mittelalterliche Rüstung | gebürsteter Stahlbrustpanzer, Kettenhemdkragen | | Aktion | heldenhaft sein | setzt eine Vorderpfote nach vorn und hält still | | Kamera | filmisch | statische Halbtotale, Augenhöhe | | Licht | dramatisches Licht | Dämmerungsseitenlicht von links, warmer Rand | | Umgebung | Burgenzeug | nasse Bodenplatten in einem laternenbeleuchteten Hof | | Maßstab | winzig und episch | kniehoch bis zum Ritter, der dahinter steht |
Zwei Muster erklären fast jedes schwache Fragment. Das erste ist Abstraktion: "heldenhaft", "episch", "filmisch" beschreiben ein Gefühl, und das Modell hat keine Pixel für ein Gefühl. Das zweite ist Scope Creep: ein einzelnes Fragment, das gleichzeitig eine Garderobenänderung, einen Ausdruckswechsel und einen Ortswechsel verlangt.
Beachte die Maßstab-Zeile. Mehrdeutiger Maßstab ist der leiseste Fehler in diesem ganzen Format, weil die Katze gut aussieht und die Welt falsch aussieht. Sag "kniehoch bis zum Ritter dahinter" statt "winzig", und der Hof, die Türrahmen und die anderen Figuren lösen sich alle in der richtigen Größe auf. Das Preset winziger Ritter und riesiger Beschützer ist ganz auf diese Beziehung ausgelegt, also ist es der schnellste Weg zu sehen, wie Maßstabssprache funktioniert.
Kamera-Sprache, die die Ausgabe verändert
Kameraanweisungen sind ein echter Parameter im Rendering, kein Fülltext. Zwei Familien decken das meiste ab, was du brauchst.
Statische Aufnahmen halten den Bildausschnitt still, während sich das Subjekt bewegt. Eine statische Aufnahme ist die stabilste Option, weil das Modell nur eine bewegte Sache animieren muss: deine Katze. Schwenks und Pushs bedeuten, dass auch der Hintergrund in jedem Frame neu erfunden werden muss, und Hintergrunderfindung ist dort, wo Verzerrungen und Textur-Kriechen auftauchen. Wenn ein Rendering immer wieder auseinanderfällt, entferne die Kamerabewegung, bevor du irgendetwas anderes umschreibst.
Dolly und Push-in bewegen die Kamera auf das Subjekt zu oder von ihm weg. Ein langsamer Push-in liest sich als Absicht und funktioniert gut für eine stillstehende Katze, weil die Bewegung vom Bildausschnitt statt vom Tier getragen wird. Halte die Bewegung einzeln und langsam: "langsamer Dolly-in" ist stabil, "Dolly-in, dann Kran nach oben" sind zwei Bewegungen, und die zweite frisst meist die erste.
Für beide Familien gilt: Benenne den Bildausschnitt und die Höhe. "Halbtotale auf Augenhöhe" und "niedrige Weitaufnahme vom Boden" erzeugen sichtbar unterschiedliche Kompositionen, und beide sind nützlicher als nur "Nahaufnahme". Ein niedriger Winkel lässt die Katze größer erscheinen, was nützlich ist, wenn der Witz davon abhängt, dass das Tier unterschätzt wird. Eine Halbtotale auf Augenhöhe hält die Rüstungssilhouette lesbar, was meist das ist, was du willst, wenn die Garderobe der Punkt ist.
Warum eine Aktion pro Aufnahme zählt
Ein 10-second-Clip hat genug Platz für eine überzeugende Bewegung. Wenn ein Prompt zwei oder drei separate Aktionen verlangt, verteilt das Modell eine feste Menge Animation auf sie, und jede bekommt weniger. Das sichtbare Ergebnis ist eine Verwischung: Gliedmaßen, die sich nur halb bewegen, eine Drehung, die nie fertig wird, ein erhobenes Schwert, das zu einem Stahlfleck verschwimmt.
Es gibt einen zweiten Grund, und er hat mit verborgener Geometrie zu tun. Zusätzliche Gliedmaßen erscheinen, wenn der Prompt eine Körperhaltung impliziert, die das Referenzfoto nicht zeigt. Wenn dein Foto eine sitzende Katze ist und der Prompt "auf den Hinterbeinen stehen und ein Schwert schwingen" verlangt, muss das Modell den Bauch, die ausgestreckten Hinterbeine und die Pfotenposition aus dem Nichts erfinden, und oft erfindet es eine Gliedmaße zu viel oder setzt ein Bein dorthin, wo ein Schwanz sein sollte. Eine Referenzpose, die nahe an der gewünschten Aktion ist, plus eine einzige dominante Bewegung, verhindert das meiste davon.
Die praktische Regel: Wenn du den Clip mit "und dann" beschreiben kannst, teile ihn in zwei Generierungen auf. Zwei Clips zu je 30 Credits geben dir zwei brauchbare Aufnahmen. Ein Clip, der beides verlangt, liefert dir eine Verwischung, die dasselbe kostet und nicht durch erneutes Auswürfeln des Textes gerettet werden kann.
Sechs Beispiel-Prompts
Jedes Beispiel unten füllt die fünf Slots und nichts weiter. Die Formulierung ist bewusst schlicht, weil schlichte Formulierungen dem Modell weniger Raum zur Interpretation lassen.
- Marsch im Hof (mit Foto). Die Katze in der Referenz, gebürsteter Stahlbrustpanzer und Kettenhemdkragen, setzt eine Vorderpfote nach vorn auf nasse Bodenplatten und hält, statische Halbtotale auf Augenhöhe, Dämmerungsseitenlicht von links mit einem warmen Rand auf der Rüstung.
- Wachdienst (mit Foto). Die Katze in der Referenz, verbeulter Eisenhelm und ein tief gehaltenes Kurzschwert, sitzt still, während Regen am Bild vorbeifällt, statische Weitaufnahme aus Bodenhöhe, kaltes bewölktes Licht mit einer einzelnen Laterne rechts.
- Riesiger Beschützer (mit Foto). Die Katze in der Referenz, keine Rüstung außer einem Lederhalsband, blickt auf und hält den Blick, langsamer Dolly-in zur Halbtotale, Dämmerungs-Gegenlicht und lange Schatten auf Stein.
- Burgtor (mit Foto). Die Katze in der Referenz, Kettenhemdkragen und ein kleines Banner auf dem Rücken festgeschnallt, geht zwei Schritte auf das Tor zu und bleibt stehen, statische Halbtotale auf Augenhöhe, Fackellicht von rechts gegen blaue Abendluft.
- Text-zu-Video, Ritterkatze an einem Kamin. Eine kleine schwarze Katze mit weißem Brustfleck, Stahlbrustpanzer und Kettenhemdkragen, rollt sich enger um eine Schüssel zusammen und kommt zur Ruhe, statische Nahaufnahme auf Bodenhöhe, warmes Feuerlicht von links mit tiefem Schatten dahinter.
- Text-zu-Video, Nachtwache. Eine stämmige rote Tabby, polierter Stahlplattenpanzer und ein auf dem Boden ruhendes Kurzschwert, hebt einmal den Kopf und hält, langsamer Dolly-in aus einer Weitaufnahme, kaltes Mondlicht durch ein schmales Fenster mit Laternenfülllicht rechts.
Die Nummern 1 bis 4 setzen ein Referenzfoto voraus, daher schrumpft der Subjekt-Slot auf eine einzelne Phrase, und das Modell übernimmt die Identitätsverankerung aus dem Bild. Die Nummern 5 und 6 enthalten die Fellbeschreibung, weil kein Foto da ist, um sie festzulegen.
Häufige Fehler
Zwei Aktionen in einer Aufnahme. Oben behandelt und immer noch die häufigste Ursache für eine Verwischung. Teile den Clip auf.
Vage Garderobe. "Rüstung" ist keine Garderobe. Benenne das Material und das Stück. "Gebürsteter Stahlbrustpanzer" und "verbeulter Eisenhelm" lösen sich in unterschiedliche Pixel auf, und das Modell wird nicht für dich wählen.
Mehrdeutiger Maßstab. "Winzig" und "episch" beschreiben dein Gefühl gegenüber der Katze, nicht ihre Größe in der Szene. Gib einen Vergleich an: "kniehoch bis zum Ritter dahinter", "kleiner als der Schild, der an der Wand lehnt".
Adjektiv-Stapelung. Vier Adjektive vor einem Substantiv teilen die Aufmerksamkeit des Modells auf alle vier auf. Wähle das eine, das zählt, und verwende deine restlichen Wörter für die Aktion.
Die Kamera mitten im Prompt wechseln. Eine Kameraanweisung pro Generierung. Ein Prompt, der gleichzeitig statische Rahmung und einen Dolly verlangt, erzeugt weder das eine noch das andere.
Wenn du die kürzere Checklisten-Version dieses Materials möchtest, deckt die Anleitung zum Erstellen eines Knight Cat AI Videos den Upload- und Preset-Ablauf rund um diese Prompts ab, und die Startseite zeigt die vier Presets, die die meisten Prompts am Ende beschreiben.
Prompt-Kosten und Iteration
Das Schreiben von Prompts ist im Vergleich zum Rendern günstig, weshalb das Iterieren am Text der richtige erste Schritt ist. Die Standard-Liefer-Spezifikation ist Standard · 1080p · 12s für 30 Credits, und die Option Standard · 720p · 12s auf den Preiskarten kostet 10 Credits. 480p-12s-Renderings kosten 5 Credits, und längere Clips skalieren linear und werden aufgerundet.
Das ist aus einem einfachen Grund wichtig: Wenn ein Rendering fehlschlägt, werden die Credits erstattet, aber ein Rendering, das erfolgreich ist und falsch aussieht, nicht. 5 Credits bei 480p sind der günstigste Weg zu testen, ob eine Aktion lesbar ist, bevor du dich für eine 1080p-Aufnahme entscheidest. Schreibe den Prompt, rendere ihn in der niedrigsten Auflösung, die die Bewegung noch zeigt, und gib erst dann die höhere Stufe aus. Du kannst die aktuellen Stufen auf der Preisseite sehen.
Neue Konten erhalten einmalig 30 Credits über die Google-Anmeldung. Die E-Mail-Registrierung beginnt bei null, bis der tägliche Check-in beansprucht wird, der 10, dann 20, dann 30, dann 10 pro Tag vier weitere Male gewährt. Renderings bleiben privat in deinem Konto, nichts wird in einen öffentlichen Feed veröffentlicht, und kein Rendering trägt ein Wasserzeichen.
FAQ
Wie lang sollte ein Prompt sein? Zwei bis vier Sätze reichen. Fünf Slots, jeweils eine Klausel. Längere Prompts teilen die Aufmerksamkeit auf mehr Objekte auf und erzeugen meist ein weicheres Ergebnis, nicht ein reicheres.
Überschreibt der Prompt mein Referenzfoto? Nein, und er sollte es nicht versuchen. Das Foto legt die Identität fest, und der Prompt beschreibt die Szene darum herum. Wenn du eine andere Katze willst, lade ein anderes Foto hoch, statt im Text ein anderes Fell zu beschreiben.
Warum bekommt meine Katze zusätzliche Gliedmaßen? Der Prompt verlangt eine Körperhaltung, die das Foto nicht zeigt. Stimme die Referenzpose auf die Aktion ab, halte eine dominante Bewegung ein, und das Modell hört auf, bei verborgener Geometrie zu raten.
Sollte ich meinen Prompt als Keywords oder als Sätze schreiben? Als Sätze mit klaren Slots. Keyword-Listen funktionieren als Notlösung, aber Sätze tragen die Beziehungen zwischen Subjekt, Aktion und Kamera, und diese Beziehungen sind das, was das Modell animiert.
Welche Kameraeinstellung sollte ich zuerst verwenden? Statisch. Sie ist die stabilste Option, und sobald das sauber rendert, kannst du als einzige Änderung einen langsamen Dolly-in hinzufügen.
Kann ich einen Prompt für alle vier Presets wiederverwenden? Nein. Die Presets sturmgepeitschtes Moor, winzige Katze mit einem riesigen Ritter, Burgtor in der Dämmerung und Wächter der Milch legen jeweils die Umgebung und den Maßstab fest, daher sollte dein Prompt darauf aufbauend Garderobe, Aktion, Kamera und Licht liefern, statt die Szene erneut zu beschreiben.