Ritterkatzen-Trend: Gepanzertes Haustier-Video erklärt
 Knight Cat AI Team
Der Ritterkatzen-Trend erklärt: Warum ein als gepanzerter Ritter verkleidetes Haustier zu Kurzform-Feeds passt, die visuelle Grammatik dahinter und wie das Haustier erkennbar bleibt.
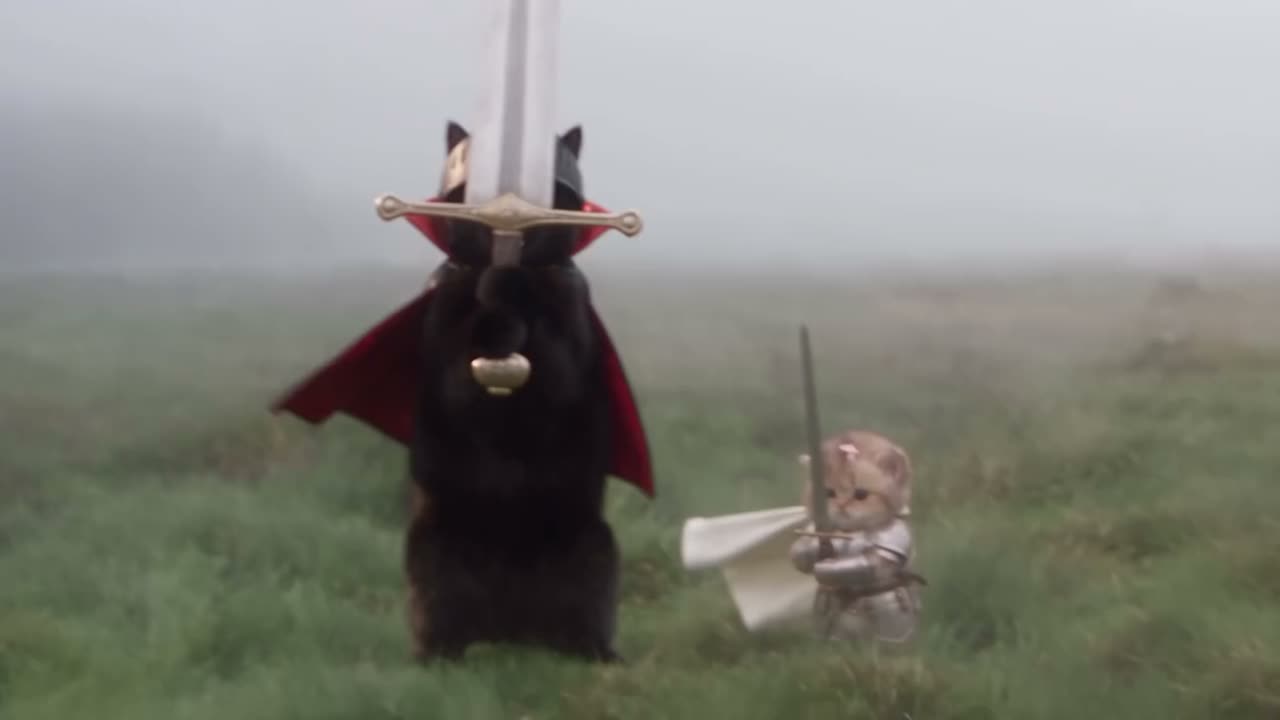
Der Ritterkatzen-Trend ist die Kurzformat-Konvention, eine gewöhnliche Hauskatze als kleinen gepanzerten mittelalterlichen Ritter in einem bewegten vertikalen Clip zu präsentieren. Das Format verbreitet sich in Kurzformat-Feeds aus drei strukturellen Gründen: Die Silhouette ist in Vorschaubildgröße sofort lesbar, der Witz überlebt stummgeschaltetes Autoplay, weil er von Kostüm und Größenverhältnis getragen wird statt von Dialog, und das Haustier bleibt erkennbar, während sich Garderobe und Setting vollständig ändern.
Was der Trend tatsächlich ist
Nimmt man die Ästhetik weg, ist der Ritterkatzen-Trend ein Ausgabeformat, keine Geschichte. Ein einzelnes Foto einer Katze dient als Subjektreferenz, eine Szenenbeschreibung liefert Garderobe, Beleuchtung und Kameravorhalten, und ein Videomodell dekodiert eine kurze Sequenz, in der dasselbe Tier in Plattenrüstung erscheint. Auf dieser Seite ist dieses Modell Seedance 2.0, und das Standardergebnis ist ein etwa zehn Sekunden langes vertikales 9:16 MP4, das du herunterladen und posten kannst, wo du möchtest.
Der Trend lässt sich am besten als Genre mit einem festen Vertrag zwischen Betrachter und Ersteller verstehen:
- Das Subjekt ist ein echtes Haustier, keine erfundene Figur, und es muss erkennbar bleiben.
- Das Kostüm ist mittelalterlich und schützend, das heißt Metall, Leder, Banner oder Fackelschein statt eines Gag-Huts.
- Der Bildausschnitt ist vertikal und die Dauer kurz, sodass die ganze Idee ankommt, bevor sich ein Daumen bewegen kann.
- Es gibt eine dominante Aktion, meist einen Blick, einen Schritt oder eine Drehung, keine Abfolge von Ereignissen.
Dieser Vertrag ist der Grund, warum ein Ritterkatzen-Clip von einem Ersteller mit einem Ritterkatzen-Clip von einem anderen verwandt wirkt. Die Presets, die mit dem Studio ausgeliefert werden, kodieren dieselbe Konvention: Storm-swept moor, Tiny cat, giant knight, Castle gate at dusk und Guardian of the milk sind vier Variationen derselben Grammatik.
Dieser Clip: 30 Credits · 6 Clips pro Monat für $39.90 (Pro) oder 80 pro Jahr für $319
Die visuelle Grammatik hinter den Clips
Drei Entscheidungen wiederholen sich in fast jedem Clip des Formats, und jede leistet eine bestimmte Arbeit.
Größenkontrast. Das Haustier ist klein und die Welt um es herum ist groß. Eine Katze, die einen bescheidenen Teil eines hohen Bildes einnimmt und von einem Tor, einem Schild oder einer gepanzerten Figur in den Schatten gestellt wird, erzeugt die Kernspannung des Genres. Wenn das Tier stattdessen das Bild füllt, liest sich der Clip nicht mehr als Ritterkatze, sondern als Haustierporträt mit Kostüm.
Warmes gerichtetes Licht. Fackelschein, tiefstehende Sonne und Feuerglut tun zwei Dinge zugleich. Sie rechtfertigen das mittelalterliche Setting und trennen Fell von Metall, weil kühles Tageslicht dazu neigt, die Rüstung in Grau zu egalisieren und die Abzeichen des Tiers zu verlieren. Warmes Licht von einer Seite gibt dem Modell außerdem eine offensichtliche Quelle zum Animieren, sodass Flackern auf einem Helm oder einer Wand als Bewegung gelesen wird, selbst wenn sich das Subjekt kaum bewegt.
Vertikaler Bildausschnitt. Ein 9:16-Bild ist hoch und schmal, was die Höhe des Subjekts belohnt. Ein stehendes Haustier, ein erhobenes Banner oder ein hoher Türrahmen füllen die Komposition auf natürliche Weise. Horizontale Gruppenszenen kämpfen gegen das Format, weil alles Wichtige am Ende zu einem Streifen in der Mitte komprimiert wird.
Das Format im Vergleich zu anderen Haustier-Videostilen
Der Ritterkatzen-Clip ist nicht die einzige Möglichkeit, ein Haustier auf einen Telefonbildschirm zu bringen. Er unterscheidet sich von benachbarten Formaten in Punkten, die leicht zu messen sind, sobald man die Spalten benennt.
| Format | Subjektkonsistenz | Bewegung | Garderobe | Dauer | | ------------------------------------------- | --------------------------------------- | ------------------------------------------- | ------------------------------ | ------------------------------------------ | | Ritterkatzen-Clip, aus einem Foto generiert | Hoch, durch das Referenzfoto festgelegt | Eine dominante Aktion, vom Modell dekodiert | Vollständig vom Modell ersetzt | Etwa 10s, 9:16 | | Gefilmter Haustier-Trick | Hoch, das Tier ist echt | Was auch immer das Tier wählt | Nur was physisch vorhanden ist | Eine Aufnahme, solange die Aufnahme dauert | | Fotodiashow mit Musik | Hoch, aber eingefroren | Schwenken, Zoomen, Schnitte | Nichts hinzugefügt | Ein kurzes Karussell oder Loop | | Generierte Szene nur aus Text | Niedriger, keine Referenz zum Verankern | Eine dominante Aktion | Vollständig generiert | Etwa 10s, 9:16 | | Kostüm-Fotoshooting | Hoch, das Tier ist echt | Statisch oder nahezu statisch | Physisches, gekauftes Kostüm | Einzelbilder |
Das Muster ist einfach. Gefilmte Clips gewinnen bei Authentizität und verlieren bei der Garderobe, weil man keine Plattenrüstung für eine Katze zu vertretbaren Kosten kaufen oder das Tier dazu bringen kann, sie zu tragen. Diashows gewinnen beim Aufwand und verlieren bei der Bewegung. Reine Textgenerierung gewinnt bei der Szenenfreiheit und verliert bei der Subjektkonsistenz, weil nichts das Fellmuster festlegt. Ein Ritterkatzen-Clip tauscht etwas Realismus gegen vollständige Kontrolle über Kostüm, Setting und Kamera, während das Haustier erkennbar bleibt, und genau dieser Tausch ist der ganze Punkt des Formats.
Warum das vertikale Format es trägt
Kurzformat-Feeds werden auf einem Telefon angesehen, das auf Armeslänge gehalten wird, häufig stummgeschaltet und mit einem schwebenden Daumen. Diese Umgebung stellt Anforderungen, die das Ritterkatzen-Format zufällig erfüllt.
Das erste Bild muss die Idee vermitteln, bevor sich etwas bewegt, deshalb beginnt ein Clip mit dem Haustier bereits in Rüstung statt mit einem Aufbau. Die wichtigen Informationen sitzen im mittleren Bereich des Bildes, weil die Ränder von Interface-Elementen verdeckt werden. Kontrast erledigt die Arbeit, die Audio in einem längeren Video tun würde, weshalb Metallreflexionen vor dunklen Hintergründen so häufig sind. Und die Aktion ist ohne Lesen verständlich, weil ein kleines Tier, das in einem großen Helm den Kopf dreht, für sich genommen ein vollständiger Beat ist.
Nichts davon hängt davon ab, dass ein bestimmter Clip gut abschneidet. Es ist einfach das, was das Format und der Feed belohnen, und das Format wurde um diese Einschränkungen herum gebaut.
Wie dasselbe Tier erkennbar bleibt
Das ist der Mechanismus, der einen Ritterkatzen-Clip von einem generischen Fantasy-Render trennt, und es lohnt sich, ihn zu verstehen, ob du selbst einen machen willst oder den Trend nur genau lesen möchtest.
Identitätsverankerung. Das Referenzfoto legt Fellmuster, Gesichtsform, Augenfarbe und Abzeichen fest. Das Modell kann die Umgebung und die Kleidung frei neu aufbauen, aber diese Identitätsmerkmale sind auf dein Bild konditioniert, sodass das Tier, das in der Rüstung erscheint, erkennbar das Tier auf dem Foto ist. Deshalb behält eine getigerte Katze ihre Tigerstreifen unter einem Brustpanzer, während das Schloss dahinter von Grund auf erfunden wird.
Eine Aktion pro Einstellung. Ein Clip, der drei separate Aktionen in zehn Sekunden verlangt, wird einige davon verwischen oder fallen lassen, weil das Modell viel Veränderung in eine kleine Anzahl von Frames komprimieren muss. Eine einzelne dominante Bewegung, etwa eine langsame Kopfdrehung oder ein bewusster Schritt, bleibt sauber.
Posenehrlichkeit. Zusätzliche Gliedmaßen erscheinen meist, wenn die angeforderte Pose eine ist, die das Referenzfoto nicht zeigt. Wenn du eine Katze verlangst, die sich auf die Hinterbeine aufrichtet, und dein Foto eine sitzende Katze zeigt, errät das Modell die verborgene Geometrie und kann falsch raten. Ein Referenzfoto, dessen Pose der Zielpose bereits ähnelt, vermeidet die meisten Fehler dieser Klasse.
Kameradisziplin. Kamerasprache ist ein echter Parameter, keine Dekoration. Eine feste Einstellung mit Umgebungsbewegung ist stabiler als ein schneller Dolly oder ein Whip Pan, weil das Modell weniger bewegliche Teile kohärent halten muss. Wenn ein Clip verzerrt aussieht, ist die Kameraanweisung oft die Ursache und nicht das Subjekt.
Wenn du sehen möchtest, wie diese vier Regeln in der Praxis angewendet werden, baut die Schritt-für-Schritt-Anleitung in wie man ein Ritterkatzen-KI-Video erstellt einen Clip aus einem einzigen Foto auf.
Was der Trend nicht ist
Mehrere Annahmen reisen mit dem Format, und die meisten sind falsch.
Er ist mit keinem Film, Spiel, Franchise oder einer realen mittelalterlichen Quelle verbunden. Die Rüstung ist generische Plattenrüstung und das Setting ist ein generisches Schloss, und kein Clip im Format ist offizielles Material für irgendetwas.
Er ist kein öffentlicher Feed. Renderings auf dieser Seite sind privat für das Konto, das sie erstellt hat, und standardmäßig wird nichts irgendwo veröffentlicht. Es gibt kein Wasserzeichen auf einem Rendering, wenn du also einen Clip postest, ist die Datei sauber.
Er ist kein Filter, der auf dein vorhandenes Filmmaterial angewendet wird. Das Video wird generiert, das heißt, die Frames existieren nicht, bis das Modell sie erzeugt. Dein Foto liefert Identität, nicht Pixel.
Er ist nicht dasselbe wie das Kätzchen-mit-einem-Schwert-Meme. Jenes Format ist ein von einer Bildunterschrift geführter Witz auf Grundlage eines einzelnen Standbilds, und der Humor entsteht aus der Diskrepanz zwischen einem harmlosen Tier und einer Waffe. Der Ritterkatzen-Clip ist eine bewegte Szene mit Kostüm, Licht und Kameraanweisung, und der Humor oder Reiz kommt aus Größenverhältnis und Produktionswert statt aus der Bildunterschrift. Der Vergleich der beiden Traditionen ist lesenswert, wenn du die Herkunft statt der Spezifikation möchtest.
Einen Clip kritisch lesen
Sobald du die Grammatik kennst, kannst du einen generierten Ritterkatzen-Clip erkennen und seine Qualität in wenigen Sekunden beurteilen.
| Prüfung | Wie ein gutes Ergebnis aussieht | Wie ein Fehler aussieht | | --------------------- | ---------------------------------------------- | -------------------------------------------------------------------- | | Pfoten und Gliedmaßen | Vier Beine, korrekte Anzahl, plausible Gelenke | Zusätzliches Gliedmaß, verschmolzene Pfote, verschwindendes Gliedmaß | | Identität | Fellmuster entspricht dem Referenztier | Muster wandert zwischen Frames oder verliert Abzeichen | | Lichtrichtung | Eine konsistente Quelle, stabile Schatten | Schatten wechselt mitten im Clip die Richtung | | Kamera | Fixiert oder gleichmäßig fahrend | Verzerrte Ränder, gummiartiger Hintergrund |
Diese Prüfungen sagen dir auch, was du ändern solltest, wenn du produzierst statt zuzusehen. Fehler bei Gliedmaßen deuten auf Posenehrlichkeit hin, Musterabweichungen deuten auf ein schwaches Referenzfoto hin, und Schattenwechsel deuten meist auf eine überambitionierte Kameraanweisung hin.
Einen im Format erstellen
Der Workflow ist kurz genug, um ihn in fünf Schritten zu beschreiben.
- Wähle ein Referenzfoto, auf dem die Katze klar beleuchtet ist, zur Kamera schaut und an den Beinen nicht abgeschnitten ist.
- Öffne den Generator und lade dieses einzelne Foto hoch.
- Wähle ein Preset. Castle gate at dusk und Guardian of the milk sind am nachsichtigsten, weil sie kleine Umgebungsbewegung statt einer Ganzkörperaktion implizieren.
- Generiere zuerst mit 480p, wenn du einen Prompt testest, da ein 480p-Durchlauf 5 Credits kostet und du Pose und Identität prüfen kannst, bevor du dich festlegst.
- Lade das MP4 herunter und, wenn du es posten willst, befolge die praktischen Hinweise im TikTok-Leitfaden zu Bildunterschriften und Zuschnitt.
Die Preisgestaltung erfolgt pro Rendering und wird offen veröffentlicht: Standard · 720p · 12s kostet 10 Credits, und Standard · 1080p · 12s kostet 30 Credits. Fehlgeschlagene Renderings werden auf das Guthaben zurückerstattet, von dem sie kamen, sodass ein Versuch, der verwischt zurückkommt, dich keinen echten Versuch kostet.
FAQ
Ist der Ritterkatzen-Trend dasselbe wie das Meme vom Kätzchen mit einem Schwert? Nein. Das Meme ist ein von einer Bildunterschrift geführtes Standbild. Der Trend ist ein generierter bewegter Clip mit fester visueller Grammatik, und er wird durch den Clip definiert statt durch eine Witz-Bildunterschrift.
Brauche ich Videobearbeitungskenntnisse, um mitzumachen? Nein. Du lädst ein Foto hoch und wählst ein Preset. Das Modell übernimmt Garderobe, Setting, Beleuchtung und Kamera, die nützlichen Fähigkeiten sind also, ein klares Referenzfoto auszuwählen und eine Aktion zu beschreiben.
Warum sieht dieselbe Katze unter der Rüstung wie dieselbe Katze aus? Weil das Referenzfoto die Generierung auf Fellmuster, Gesichtsform und Abzeichen konditioniert. Garderobe und Hintergrund werden neu generiert, aber die Identitätsmerkmale sind an dein Bild verankert.
Kann ich einen Clip posten, wo ich will? Renderings sind standardmäßig privat für dein Konto und tragen kein Wasserzeichen, die Datei, die du herunterlädst, ist also deine zur Nutzung. In deinem Namen wird nichts in einem öffentlichen Feed veröffentlicht.
Was ist die häufigste Ursache für ein schlechtes Rendering? Ein Prompt, der mehrere Aktionen auf einmal verlangt, oder eine Pose, die das Referenzfoto nicht zeigt. Beides zwingt das Modell, Geometrie zu erfinden, und daher kommen zusätzliche Gliedmaßen und Verwischen.
Wenn du den weiteren Kontext des Formats möchtest, bevor du etwas generierst, beginnen der Blog-Index und die Produktübersicht beide mit derselben Definition: ein kurzer vertikaler Clip, in dem ein echtes Haustier als kleiner gepanzerter Ritter auftritt, während es erkennbar bleibt.