Prompts de vídeo de Knight Cat AI: una estructura que funciona
 Knight Cat AI Team
Los prompts de vídeo de Knight Cat AI necesitan cinco campos ordenados: sujeto, vestuario, una acción, cámara e iluminación. Primero la estructura, los adjetivos al final y una toma por cada uno.
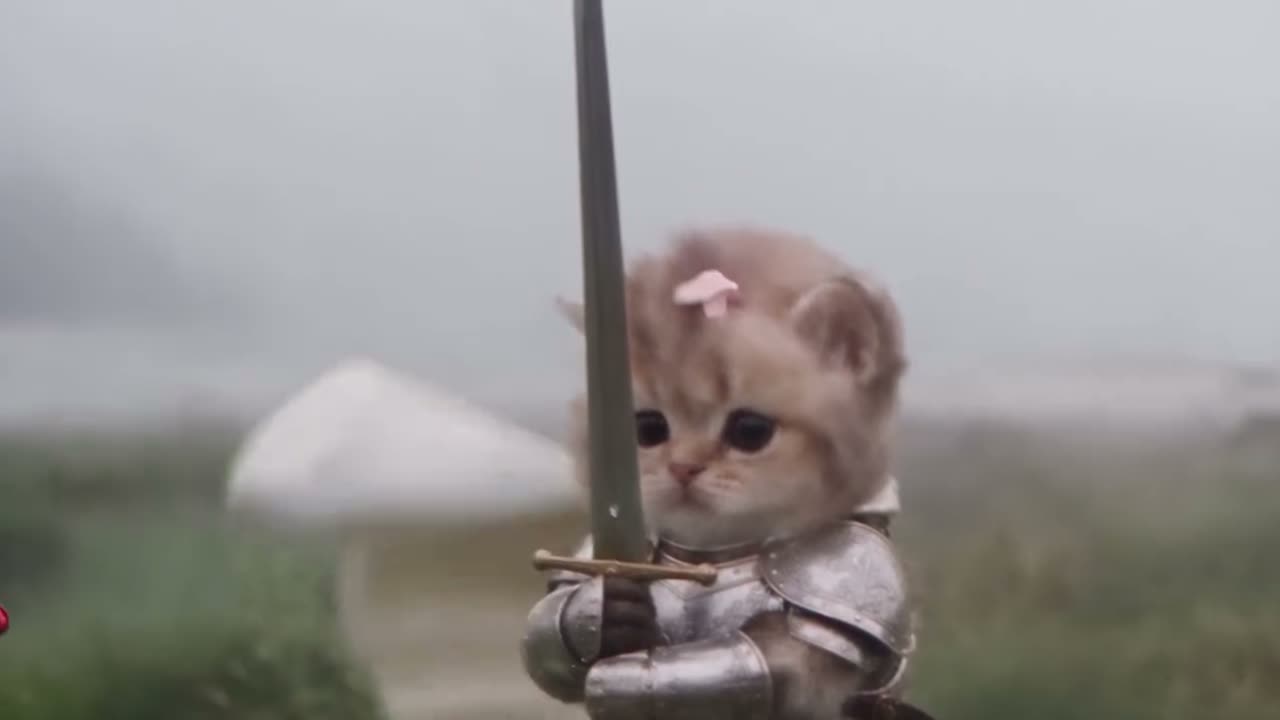
Un buen prompt de vídeo con IA de Knight Cat AI llena cinco espacios en un orden fijo: sujeto, vestuario, una acción, cámara, iluminación. Todo lo demás que quieras añadir es decoración, y la decoración es la parte que hace que un render de 10 segundos se emborrone. Esta guía cubre las dos rutas de prompt que admite el estudio, los patrones de fragmentos que se sostienen, el vocabulario de cámara que realmente cambia la salida y los tres modos de fallo que explican la mayoría de los renders defectuosos.
Las dos rutas de prompt
El estudio acepta una foto de referencia o una descripción de texto, y el prompt que escribas se comporta de forma distinta según cuál le des.
Si subes una foto, tu prompt de texto no necesita describir al gato. La foto ya fija el patrón de pelaje, la forma de la cara, la posición de las orejas y las marcas mediante el anclaje de identidad, que es el mecanismo que mantiene reconocible a tu mascota mientras el modelo cambia el vestuario y el escenario. Tus palabras deberían describir, en cambio, la escena en la que se coloca al gato: qué lleva puesto, qué hace, dónde está la cámara y cómo cae la luz.
Si no das ninguna foto, el prompt también tiene que cargar con el sujeto. Eso significa nombrar la silueta de la raza, el color y el patrón del pelaje, y la pose corporal desde la que quieres que parta el modelo. Texto a vídeo es más flexible porque nada restringe la composición, y menos indulgente porque nada ancla tampoco la identidad. Un prompt sin foto y sin descripción del pelaje produce un gato armado genérico que se parece a tu mascota solo por especie.
Empieza en el generador de vídeo con IA de Knight Cat AI si quieres ver ambas entradas en paralelo antes de escribir nada.
La estructura de prompt de cinco espacios
Escribe tu prompt como cinco frases cortas en este orden. El orden importa menos que la disciplina de llenar cada espacio una vez.
- Sujeto — quién está en pantalla. Con una foto de referencia, es una sola palabra como "el gato de la referencia". Sin una, da color de pelaje, patrón y complexión: "un pequeño atigrado gris con calcetines blancos y la oreja izquierda recortada".
- Vestuario — una capa de armadura y un objeto llevado, nada más. "Peto de acero cepillado, collar de cota de malla, una espada corta sostenida en la pata derecha" está completo. Añadir una capa, un casco, un escudo y un estandarte le da al modelo cinco objetos que resolver en 10 segundos y dejará caer o fusionará algunos.
- Una acción — un único movimiento dominante para todo el clip. "Da un paso hacia delante sobre un escalón de piedra" es un plano. "Da un paso hacia delante, mira hacia arriba y luego levanta la espada" son tres planos comprimidos en uno, y el resultado es un emborronamiento.
- Cámara — cómo se mueve el encuadre. "Plano medio fijo" o "dolly lento hacia delante sobre las patas". Una instrucción de cámara por prompt.
- Iluminación — hora del día y dirección. "Luz baja de atardecer desde la izquierda, borde cálido en el filo de la armadura" supera a "iluminación cinematográfica", que no le dice al modelo nada sobre lo que pueda actuar.
Un prompt construido así se lee como una lista de planos en lugar de un deseo. Ese es el punto: Seedance 2.0 renderiza lo que puede resolver fotograma a fotograma, y cada espacio que llenas reduce el número de decisiones que tiene que adivinar.
Este clip: 30 créditos · 6 clips al mes por $39.90 (Pro), o 80 al año por $319
Fragmentos fuertes frente a débiles
La diferencia entre un prompt usable y una generación desperdiciada suele estar en una o dos elecciones de palabras. La tabla siguiente empareja fragmentos que se resuelven limpiamente con fragmentos que no.
| Espacio | Fragmento débil | Fragmento fuerte | | ----------- | ----------------- | ------------------------------------------------------------ | | Sujeto | un gato lindo | atigrado gris, calcetines blancos, oreja izquierda recortada | | Vestuario | armadura medieval | peto de acero cepillado, collar de cota de malla | | Acción | ser heroico | planta una pata delantera hacia delante y se queda quieto | | Cámara | cinematográfico | plano medio fijo, a la altura de los ojos | | Iluminación | luz dramática | luz lateral de atardecer desde la izquierda, borde cálido | | Escenario | cosas de castillo | losas húmedas en un patio iluminado por faroles | | Escala | diminuto y épico | a la altura de la rodilla del caballero que está detrás |
Dos patrones explican casi todos los fragmentos débiles. El primero es la abstracción: "heroico", "épico", "cinematográfico" describen un sentimiento, y el modelo no tiene píxeles para un sentimiento. El segundo es la expansión del alcance: un único fragmento que pide un cambio de vestuario, un cambio de expresión y un cambio de ubicación a la vez.
Fíjate en la fila de escala. La escala ambigua es el fallo más silencioso de todo este formato, porque el gato se ve bien y el mundo se ve mal. Di "a la altura de la rodilla del caballero que está detrás" en lugar de "diminuto", y el patio, los marcos de las puertas y las demás figuras se resuelven todos al tamaño correcto. El preajuste pequeño caballero y protector gigante está construido enteramente en torno a esa relación, así que es la forma más rápida de ver funcionar el lenguaje de escala.
Lenguaje de cámara que cambia la salida
Las instrucciones de cámara son un parámetro real en el render, no texto de relleno. Dos familias cubren la mayor parte de lo que necesitas.
Planos fijos mantienen el encuadre quieto mientras el sujeto se mueve. Un plano fijo es la opción más estable, porque el modelo solo tiene que animar una cosa en movimiento: tu gato. Los paneos y los empujes significan que el fondo también tiene que reinventarse en cada fotograma, y la reinvención del fondo es donde aparecen la deformación y el arrastre de textura. Si un render no deja de desmoronarse, elimina el movimiento de cámara antes de reescribir cualquier otra cosa.
Dolly y acercamiento mueven la cámara hacia el sujeto o lejos de él. Un acercamiento lento se lee como intención y funciona bien para un gato quieto, porque el movimiento lo lleva el encuadre en lugar del animal. Mantén el movimiento único y lento: "dolly lento hacia delante" es estable, "dolly hacia delante y luego grúa hacia arriba" son dos movimientos y el segundo suele comerse al primero.
Para cualquiera de las dos familias, nombra el encuadre y la altura. "Plano medio a la altura de los ojos" y "plano general bajo desde el suelo" producen composiciones visiblemente distintas, y ambos son más útiles que "primer plano" por sí solo. Un ángulo bajo hace que el gato se perciba más grande, lo cual es útil cuando el chiste depende de que se subestime al animal. Un plano medio a la altura de los ojos mantiene legible la silueta de la armadura, que suele ser lo que quieres cuando el vestuario es lo importante.
Por qué importa una acción por plano
Un clip de 10 segundos tiene espacio suficiente para un movimiento convincente. Cuando un prompt pide dos o tres acciones separadas, el modelo distribuye una cantidad fija de animación entre ellas y cada una recibe menos. El resultado visible es un emborronamiento: extremidades que se mueven a medias, un giro que nunca se completa, una espada levantada que se convierte en una mancha de acero.
Hay una segunda razón, y tiene que ver con la geometría oculta. Las extremidades extra aparecen cuando el prompt implica una pose corporal que la foto de referencia no muestra. Si tu foto es un gato sentado y el prompt pide "de pie sobre las patas traseras y blandiendo una espada", el modelo tiene que inventar la barriga, las patas traseras extendidas y la posición de la pata desde la nada, y a menudo inventa una extremidad de más o pone una pata donde debería ir una cola. Una pose de referencia que se acerque a la acción que quieres, más un único movimiento dominante, evita la mayor parte.
La regla práctica: si puedes describir el clip con "y luego", divídelo en dos generaciones. Dos clips a 30 créditos cada uno te dan dos planos usables. Un clip que pida ambos te da un emborronamiento que cuesta lo mismo y no se puede salvar volviendo a lanzar el texto.
Seis prompts de ejemplo
Cada ejemplo a continuación llena los cinco espacios y nada más. La redacción es deliberadamente sencilla, porque una redacción sencilla deja menos espacio para que el modelo interprete.
- Marcha en el patio (con foto). El gato de la referencia, peto de acero cepillado y collar de cota de malla, planta una pata delantera hacia delante sobre losas húmedas y se queda quieto, plano medio fijo a la altura de los ojos, luz lateral de atardecer desde la izquierda con un borde cálido en la armadura.
- Servicio de guardia (con foto). El gato de la referencia, yelmo de hierro abollado y una espada corta sostenida baja, se queda sentado quieto mientras la lluvia cae más allá del encuadre, plano general fijo desde la altura del suelo, luz fría de cielo cubierto con un único farol a la derecha.
- Protector gigante (con foto). El gato de la referencia, sin armadura excepto un collar de cuero, mira hacia arriba y mantiene la mirada, dolly lento hacia delante hasta un plano medio, contraluz de atardecer y sombras largas sobre piedra.
- Puerta del castillo (con foto). El gato de la referencia, collar de cota de malla y un pequeño estandarte atado a la espalda, camina dos pasos hacia la puerta y se detiene, plano medio fijo a la altura de los ojos, luz de antorcha desde la derecha contra el aire azul del anochecer.
- Texto a vídeo, gato caballero junto a una chimenea. Un gato negro pequeño con una mancha blanca en el pecho, peto de acero y collar de cota de malla, se enrosca más apretado alrededor de un cuenco y se acomoda, plano cercano fijo a la altura del suelo, luz cálida de fuego desde la izquierda con sombra profunda detrás.
- Texto a vídeo, guardia nocturna. Un atigrado naranja rechoncho, placas de acero pulido y una espada corta apoyada en el suelo, levanta la cabeza una vez y la mantiene, dolly lento hacia delante desde un plano general, luz de luna fría a través de una ventana estrecha con relleno de farol a la derecha.
Los números 1 a 4 asumen una foto de referencia, así que el espacio del sujeto se reduce a una sola frase y el modelo hace el anclaje de identidad a partir de la imagen. Los números 5 y 6 llevan la descripción del pelaje porque no hay foto que la fije.
Errores comunes
Dos acciones en un plano. Ya se ha tratado arriba, y sigue siendo la causa más común de un emborronamiento. Divide el clip.
Vestuario vago. "Armadura" no es un vestuario. Nombra el material y la pieza. "Peto de acero cepillado" y "yelmo de hierro abollado" se resuelven en píxeles distintos, y el modelo no elegirá por ti.
Escala ambigua. "Diminuto" y "épico" describen tu sentimiento sobre el gato, no su tamaño en la escena. Da una comparación: "a la altura de la rodilla del caballero que está detrás", "más pequeño que el escudo apoyado en la pared".
Acumulación de adjetivos. Cuatro adjetivos delante de un sustantivo dividen la atención del modelo entre los cuatro. Elige el que importa y gasta tus palabras restantes en la acción.
Cambiar la cámara a mitad del prompt. Una instrucción de cámara por generación. Un prompt que pide encuadre fijo y dolly a la vez no produce ninguno de los dos.
Si quieres la versión más corta en forma de lista de comprobación de este material, el tutorial cómo hacer un vídeo con IA de Knight Cat AI cubre el flujo de subida y preajustes en torno a estos prompts, y la página de inicio muestra los cuatro preajustes que la mayoría de los prompts acaban describiendo.
Coste del prompt e iteración
Escribir prompts es barato en comparación con renderizar, por eso iterar sobre el texto es el primer movimiento correcto. La especificación de entrega predeterminada es Standard 1080p a 12s por 30 créditos, y la opción Standard 720p de 12s en las tarjetas de precios es de 10 créditos. Los renders de 480p a 12s cuestan 5 créditos, y los clips más largos escalan linealmente y se redondean hacia arriba.
Eso importa por una razón sencilla: si un render falla, se reembolsan los créditos, pero un render que se completa y se ve mal no. 5 créditos a 480p es la forma más barata de probar si una acción se lee antes de comprometerte con una toma en 1080p. Escribe el prompt, renderízalo a la resolución más baja que aún muestre el movimiento y solo entonces gasta el nivel superior. Puedes ver los niveles actuales en la página de precios.
Las cuentas nuevas reciben 30 créditos una vez mediante el inicio de sesión con Google. El registro con correo electrónico empieza en cero hasta que se reclama el check-in diario, que otorga 10, luego 20, luego 30, luego 10 por día cuatro veces más. Los renders permanecen privados en tu cuenta, nada se publica en un feed público y ningún render lleva marca de agua.
Preguntas frecuentes
¿Qué longitud debería tener un prompt? Dos a cuatro frases son suficientes. Cinco espacios, una cláusula cada uno. Los prompts más largos dividen la atención entre más objetos y suelen producir un resultado más blando, no más rico.
¿El prompt anula mi foto de referencia? No, y no debería intentarlo. La foto fija la identidad y el prompt describe la escena a su alrededor. Si quieres un gato diferente, sube una foto diferente en lugar de describir otro pelaje en el texto.
¿Por qué a mi gato le crecen extremidades extra? El prompt está pidiendo una pose corporal que la foto no muestra. Haz coincidir la pose de referencia con la acción, mantén un único movimiento dominante y el modelo dejará de adivinar la geometría oculta.
¿Debería escribir mi prompt como palabras clave o como frases? Frases con espacios claros. Las listas de palabras clave funcionan como respaldo, pero las frases llevan las relaciones entre sujeto, acción y cámara, y esas relaciones son lo que el modelo anima.
¿Qué ajuste de cámara debería usar primero? Fijo. Es la opción más estable, y una vez que eso se renderiza limpiamente puedes añadir un dolly lento hacia delante como único cambio.
¿Puedo reutilizar un prompt para los cuatro preajustes? No. Los preajustes de páramo azotado por la tormenta, gato diminuto con un caballero gigante, puerta del castillo al atardecer y guardián de la leche fijan cada uno el escenario y la escala, así que tu prompt debería aportar vestuario, acción, cámara e iluminación además de eso, en lugar de repetir la escena.