Prompts vidéo Knight Cat AI : une structure qui fonctionne
 Knight Cat AI Team
Les prompts vidéo Knight Cat AI nécessitent cinq champs ordonnés : sujet, garde-robe, une action, caméra et éclairage. La structure d'abord, les adjectifs en dernier, un plan par prompt.
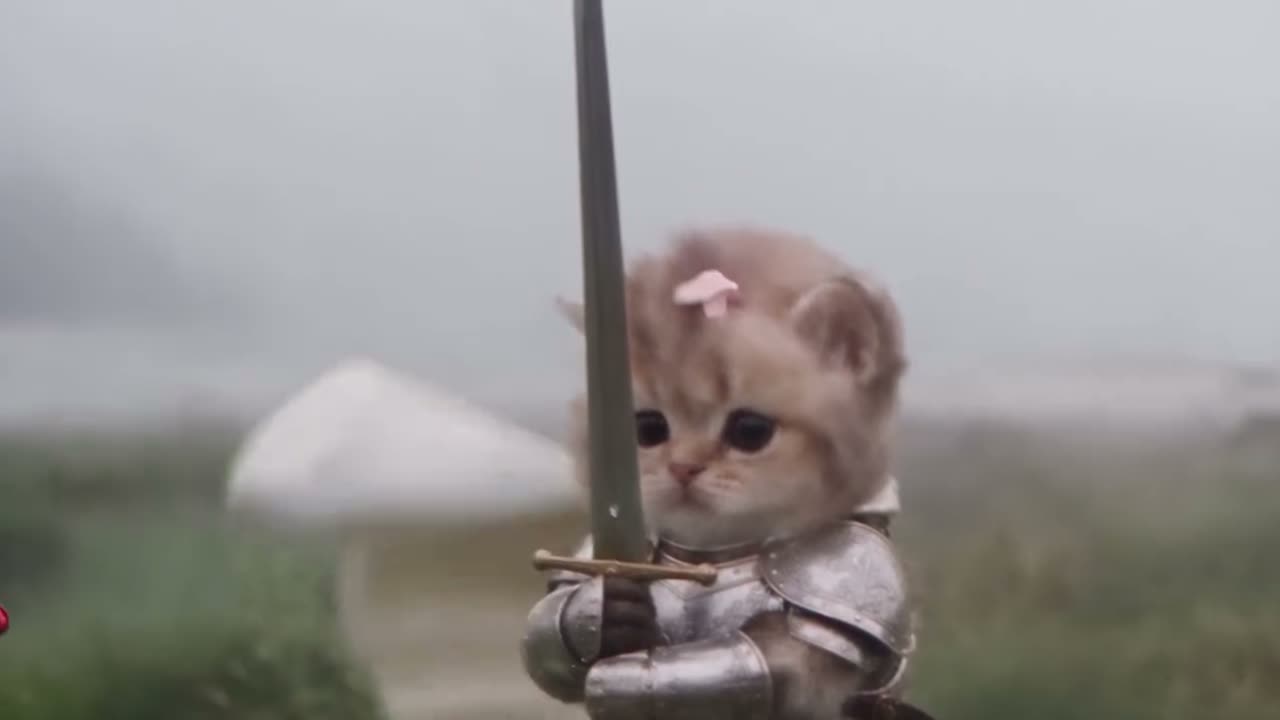
Un bon prompt de vidéo IA de chat chevalier remplit cinq emplacements dans un ordre fixe : sujet, garde-robe, une action, caméra, éclairage. Tout ce que vous pourriez vouloir ajouter en plus est décoration, et la décoration est la partie qui fait baver un rendu de dix secondes. Ce guide couvre les deux parcours de prompt pris en charge par le studio, les schémas de fragments qui tiennent, le vocabulaire de caméra qui change réellement le résultat, et les trois modes d’échec responsables de la plupart des mauvais rendus.
Les deux parcours de prompt
Le studio accepte soit une photo de référence, soit une description textuelle, et le prompt que vous écrivez se comporte différemment selon ce que vous lui donnez.
Si vous téléversez une photo, votre prompt textuel n’a pas besoin de décrire le chat. La photo fixe déjà le motif de fourrure, la forme du visage, la position des oreilles et les marques grâce à l’ancrage d’identité, le mécanisme qui garde votre animal reconnaissable pendant que le modèle change la garde-robe et le décor. Vos mots doivent plutôt décrire la scène dans laquelle le chat est déposé : ce qu’il porte, ce qu’il fait, où se trouve la caméra et comment la lumière tombe.
Si vous ne donnez aucune photo, le prompt doit aussi porter le sujet. Cela signifie nommer la silhouette de la race, la couleur et le motif du pelage, et la pose du corps à partir de laquelle vous voulez que le modèle démarre. Le texte-vers-vidéo est plus flexible parce que rien ne contraint la composition, et moins indulgent parce que rien n’ancre l’identité non plus. Un prompt sans photo et sans description du pelage produit un chat en armure générique qui ne ressemble à votre animal que par l’espèce.
Commencez sur le générateur de vidéo IA de chat chevalier si vous voulez voir les deux entrées côte à côte avant d’écrire quoi que ce soit.
La structure de prompt à cinq emplacements
Écrivez votre prompt sous forme de cinq phrases courtes dans cet ordre. L’ordre compte moins que la discipline de remplir chaque emplacement une fois.
- Sujet — qui est à l’écran. Avec une photo de référence, c’est un seul mot comme « le chat de la référence ». Sans photo, donnez la couleur du pelage, le motif et la carrure : « un petit chat tigré gris avec des chaussettes blanches et une oreille gauche entaillée ».
- Garde-robe — une couche d’armure et un objet porté, pas plus. « Plastron en acier brossé, col en cotte de mailles, une épée courte tenue dans la patte droite » est complet. Ajouter une cape, un casque, un bouclier et une bannière donne au modèle cinq objets à résoudre en 10 secondes et il en abandonnera ou en fusionnera certains.
- Une action — un seul mouvement dominant pour tout le clip. « Avance sur une marche en pierre » est un plan. « Avance, lève les yeux, puis brandit l’épée » correspond à trois plans compressés en un, et le résultat est une bavure.
- Caméra — comment le cadre bouge. « Plan moyen fixe » ou « lent travelling avant sur les pattes ». Une seule instruction de caméra par prompt.
- Éclairage — moment de la journée et direction. « Lumière basse de crépuscule venant de la gauche, liseré chaud sur le bord de l’armure » vaut mieux que « éclairage cinématographique », qui ne dit rien au modèle sur quoi agir.
Un prompt construit de cette façon se lit comme une liste de plans plutôt qu’un souhait. C’est le but : Seedance 2.0 rend ce qu’il peut résoudre image par image, et chaque emplacement que vous remplissez réduit le nombre de décisions qu’il doit deviner.
Ce clip : 30 crédits · 6 clips par mois pour $39.90 (Pro), ou 80 par an pour $319
Fragments solides contre fragments faibles
La différence entre un prompt utilisable et une génération gâchée tient généralement à un ou deux choix de mots. Le tableau ci-dessous associe des fragments qui se résolvent proprement à des fragments qui ne le font pas.
| Emplacement | Fragment faible | Fragment solide | | ----------- | ------------------- | ---------------------------------------------------------------- | | Sujet | un chat mignon | chat tigré gris, chaussettes blanches, oreille gauche entaillée | | Garde-robe | armure médiévale | plastron en acier brossé, col en cotte de mailles | | Action | fait le héros | pose une patte avant en avant et reste immobile | | Caméra | cinématographique | plan moyen fixe, à hauteur des yeux | | Éclairage | lumière dramatique | lumière latérale de crépuscule venant de la gauche, liseré chaud | | Décor | trucs de château | dalles mouillées dans une cour éclairée par des lanternes | | Échelle | minuscule et épique | à hauteur de genou pour le chevalier debout derrière lui |
Deux schémas expliquent presque tous les fragments faibles. Le premier est l’abstraction : « héroïque », « épique », « cinématographique » décrivent un ressenti, et le modèle n’a pas de pixels pour un ressenti. Le second est la dérive du périmètre : un seul fragment qui demande à la fois un changement de garde-robe, un changement d’expression et un changement de lieu.
Remarquez la ligne sur l’échelle. Une échelle ambiguë est l’échec le plus silencieux de tout ce format, parce que le chat a l’air correct et que le monde a l’air faux. Dites « à hauteur de genou pour le chevalier derrière lui » plutôt que « minuscule », et la cour, les cadres de porte et les autres figures se résolvent tous à la bonne taille. Le préréglage petit chevalier et protecteur géant est entièrement construit autour de cette relation, c’est donc le moyen le plus rapide de voir le langage d’échelle fonctionner.
Le langage de caméra qui change le résultat
Les instructions de caméra sont un vrai paramètre du rendu, pas un texte d’ambiance. Deux familles couvrent la plupart de vos besoins.
Les plans fixes gardent le cadre immobile pendant que le sujet bouge. Un plan fixe est l’option la plus stable, parce que le modèle n’a qu’une seule chose en mouvement à animer : votre chat. Les panoramiques et les travellings avant signifient que l’arrière-plan doit aussi être réinventé à chaque image, et c’est dans cette réinvention de l’arrière-plan qu’apparaissent les déformations et le rampement de texture. Si un rendu continue de s’effondrer, supprimez le mouvement de caméra avant de réécrire quoi que ce soit d’autre.
Travelling et push-in déplacent la caméra vers ou loin du sujet. Un lent push-in se lit comme une intention et fonctionne bien pour un chat immobile, parce que le mouvement est porté par le cadre plutôt que par l’animal. Gardez le mouvement unique et lent : « lent travelling avant » est stable, « travelling avant puis grue vers le haut » correspond à deux mouvements et le second mange généralement le premier.
Pour l’une ou l’autre famille, nommez le cadrage et la hauteur. « Plan moyen à hauteur des yeux » et « plan large bas depuis le sol » produisent des compositions visiblement différentes, et les deux sont plus utiles que « gros plan » seul. Un angle bas fait paraître le chat plus grand, ce qui est utile quand la blague dépend du fait que l’animal soit sous-estimé. Un plan moyen à hauteur des yeux garde la silhouette de l’armure lisible, ce qui est généralement ce que vous voulez quand la garde-robe est le sujet.
Pourquoi une action par plan compte
Un clip de dix secondes a assez de place pour un seul mouvement convaincant. Quand un prompt demande deux ou trois actions distinctes, le modèle répartit une quantité fixe d’animation entre elles et chacune en reçoit moins. Le résultat visible est une bavure : des membres qui bougent à moitié, une rotation qui ne se termine jamais, une épée levée qui se transforme en flou d’acier.
Il y a une seconde raison, liée à la géométrie cachée. Des membres supplémentaires apparaissent quand le prompt implique une pose du corps que la photo de référence ne montre pas. Si votre photo est un chat assis et que le prompt demande « debout sur les pattes arrière en train de brandir une épée », le modèle doit inventer le ventre, les pattes arrière étendues et la position de la patte à partir de rien, et il invente souvent un membre de trop ou place une patte là où devrait être une queue. Une pose de référence proche de l’action que vous voulez, plus un seul mouvement dominant, en empêche la plupart.
La règle pratique : si vous pouvez décrire le clip avec « et puis », divisez-le en deux générations. Deux clips à 30 crédits chacun vous donnent deux plans utilisables. Un clip qui demande les deux vous donne une bavure qui coûte la même chose et ne peut pas être sauvée en relançant le texte.
Six exemples de prompts
Chaque exemple ci-dessous remplit les cinq emplacements et rien de plus. Le libellé est volontairement simple, parce qu’un libellé simple laisse moins de place à l’interprétation du modèle.
- Marche dans la cour (avec photo). Le chat de la référence, plastron en acier brossé et col en cotte de mailles, pose une patte avant sur des dalles mouillées et reste immobile, plan moyen fixe à hauteur des yeux, lumière latérale de crépuscule venant de la gauche avec un liseré chaud sur l’armure.
- Garde (avec photo). Le chat de la référence, heaume en fer bosselé et une épée courte tenue bas, reste assis pendant que la pluie tombe devant le cadre, plan large fixe depuis la hauteur du sol, lumière froide couverte avec une seule lanterne à droite.
- Protecteur géant (avec photo). Le chat de la référence, aucune armure sauf un collier en cuir, lève les yeux et soutient le regard, lent travelling avant vers un plan moyen, contre-jour de crépuscule et longues ombres sur la pierre.
- Porte du château (avec photo). Le chat de la référence, col en cotte de mailles et une petite bannière attachée à son dos, avance de deux pas vers la porte et s’arrête, plan moyen fixe à hauteur des yeux, lumière de torche venant de la droite contre l’air bleu du soir.
- Texte-vers-vidéo, chat chevalier près d’un foyer. Un petit chat noir avec une tache blanche sur le poitrail, plastron en acier et col en cotte de mailles, se pelotonne plus étroitement autour d’un bol et se cale, gros plan fixe au niveau du sol, lumière chaude de feu venant de la gauche avec une ombre profonde derrière.
- Texte-vers-vidéo, veille nocturne. Un chat tigré roux trapu, armure d’acier polie et une épée courte posée au sol, lève la tête une fois et la maintient, lent travelling avant depuis un plan large, clair de lune froid à travers une fenêtre étroite avec un remplissage de lanterne à droite.
Les numéros 1 à 4 supposent une photo de référence, donc l’emplacement du sujet se réduit à une seule phrase et le modèle effectue l’ancrage d’identité à partir de l’image. Les numéros 5 et 6 portent la description du pelage parce qu’il n’y a pas de photo pour la fixer.
Erreurs courantes
Deux actions dans un plan. Traité ci-dessus, et toujours la cause la plus fréquente d’une bavure. Divisez le clip.
Garde-robe vague. « Armure » n’est pas une garde-robe. Nommez la matière et la pièce. « Plastron en acier brossé » et « heaume en fer bosselé » se résolvent en pixels différents, et le modèle ne choisira pas pour vous.
Échelle ambiguë. « Minuscule » et « épique » décrivent votre ressenti à propos du chat, pas sa taille dans la scène. Donnez une comparaison : « à hauteur de genou pour le chevalier derrière lui », « plus petit que le bouclier appuyé contre le mur ».
Empilement d’adjectifs. Quatre adjectifs devant un seul nom divisent l’attention du modèle entre les quatre. Choisissez celui qui compte et consacrez vos mots restants à l’action.
Changer la caméra en cours de prompt. Une seule instruction de caméra par génération. Un prompt qui demande à la fois un cadrage fixe et un travelling ne produit ni l’un ni l’autre.
Si vous voulez la version courte sous forme de liste de vérification de ce contenu, le tutoriel comment créer une vidéo IA de chat chevalier couvre le flux de téléversement et de préréglages autour de ces prompts, et la page d’accueil montre les quatre préréglages que la plupart des prompts finissent par décrire.
Coût et itération du prompt
Écrire un prompt est bon marché par rapport au rendu, c’est pourquoi itérer sur le texte est la bonne première étape. La spécification de livraison par défaut est Standard 1080p à 12 secondes pour 30 crédits, et l’option Standard 720p de 12 secondes sur les cartes de tarification est à 10 crédits. Les rendus 480p de 12 secondes coûtent 5 crédits, et les clips plus longs augmentent linéairement et sont arrondis à l’entier supérieur.
Cela compte pour une raison simple : si un rendu échoue, les crédits sont remboursés, mais un rendu qui réussit et qui a l’air faux ne l’est pas. 5 crédits en 480p est le moyen le moins cher de tester si une action se lit avant de vous engager sur une prise en 1080p. Écrivez le prompt, rendez-le à la résolution la plus basse qui montre encore le mouvement, et seulement ensuite dépensez le palier supérieur. Vous pouvez voir les paliers actuels sur la page de tarification.
Les nouveaux comptes reçoivent 30 crédits une fois via la connexion Google. L’inscription par e-mail commence à zéro jusqu’à ce que la vérification quotidienne soit réclamée, ce qui accorde 10, puis 20, puis 30, puis 10 par jour quatre fois de plus. Les rendus restent privés sur votre compte, rien n’est publié dans un flux public, et aucun rendu ne porte de filigrane.
FAQ
Quelle longueur doit faire un prompt ? Deux à quatre phrases suffisent. Cinq emplacements, une proposition chacun. Les prompts plus longs divisent l’attention entre plus d’objets et produisent généralement un résultat plus mou, pas plus riche.
Le prompt remplace-t-il ma photo de référence ? Non, et il ne devrait pas essayer. La photo fixe l’identité et le prompt décrit la scène autour d’elle. Si vous voulez un autre chat, téléversez une autre photo plutôt que de décrire un autre pelage dans le texte.
Pourquoi mon chat développe-t-il des membres supplémentaires ? Le prompt demande une pose du corps que la photo ne montre pas. Faites correspondre la pose de référence à l’action, gardez un seul mouvement dominant, et le modèle cesse de deviner la géométrie cachée.
Dois-je écrire mon prompt sous forme de mots-clés ou de phrases ? Des phrases avec des emplacements clairs. Les listes de mots-clés fonctionnent comme solution de repli, mais les phrases portent les relations entre sujet, action et caméra, et ce sont ces relations que le modèle anime.
Quel réglage de caméra dois-je utiliser en premier ? Fixe. C’est l’option la plus stable, et une fois que cela rend proprement, vous pouvez ajouter un lent travelling avant comme seul changement.
Puis-je réutiliser un seul prompt pour les quatre préréglages ? Non. Les préréglages lande balayée par la tempête, petit chat avec un chevalier géant, porte du château au crépuscule et gardien du lait définissent chacun le décor et l’échelle, donc votre prompt doit fournir la garde-robe, l’action, la caméra et l’éclairage en plus, plutôt que de reformuler la scène.