Prompt video Knight Cat AI: una struttura che funziona
 Knight Cat AI Team
I prompt video di Knight Cat AI richiedono cinque slot ordinati: soggetto, guardaroba, un'azione, macchina da presa e illuminazione. Prima la struttura, gli aggettivi alla fine, una ripresa ciascuno.
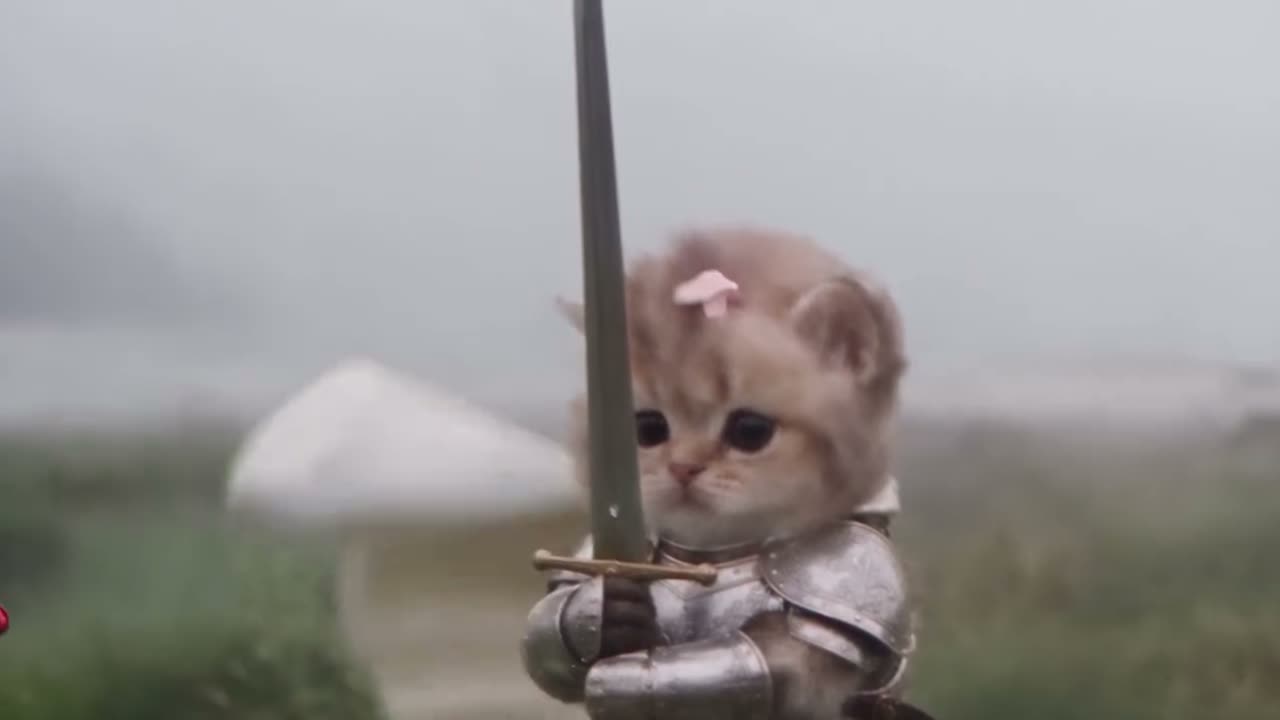
Un buon prompt per video AI di gatti cavalieri riempie cinque slot in un ordine fisso: soggetto, guardaroba, una azione, camera, illuminazione. Tutto il resto che potresti voler aggiungere è decorazione, e la decorazione è la parte che fa sbavare un render di dieci secondi. Questa guida copre i due percorsi di prompt supportati dallo studio, i pattern di frammenti che reggono, il vocabolario di camera che cambia davvero l'output e le tre modalità di errore che causano la maggior parte dei render sbagliati.
I due percorsi del prompt
Lo studio accetta una foto di riferimento oppure una descrizione testuale, e il prompt che scrivi si comporta diversamente a seconda di quale dei due fornisci.
Se carichi una foto, il tuo prompt testuale non deve descrivere il gatto. La foto fissa già il motivo del pelo, la forma del muso, la posizione delle orecchie e i segni tramite l'ancoraggio dell'identità, il meccanismo che mantiene riconoscibile il tuo animale domestico mentre il modello cambia guardaroba e ambientazione. Le tue parole dovrebbero invece descrivere la scena in cui viene calato il gatto: cosa indossa, cosa fa, dove si trova la camera e come cade la luce.
Se non fornisci alcuna foto, il prompt deve portare anche il soggetto. Ciò significa nominare la silhouette della razza, il colore e il motivo del mantello e la posa del corpo da cui vuoi che il modello parta. Il text-to-video è più flessibile perché nulla vincola la composizione, e meno indulgente perché nulla ancora l'identità. Un prompt senza foto e senza descrizione del mantello produce un gatto corazzato generico che somiglia al tuo animale domestico solo per specie.
Inizia dal generatore video AI di gatti cavalieri se vuoi vedere entrambi gli input affiancati prima di scrivere qualsiasi cosa.
La struttura del prompt in cinque slot
Scrivi il tuo prompt come cinque brevi frasi in questo ordine. L'ordine conta meno della disciplina di riempire ogni slot una volta.
- Soggetto — chi è sullo schermo. Con una foto di riferimento, è una singola parola come "il gatto nel riferimento". Senza, fornisci colore del mantello, motivo e corporatura: "un piccolo soriano grigio con calzini bianchi e un orecchio sinistro tagliato".
- Guardaroba — uno strato di armatura e un oggetto trasportato, non di più. "Corazza in acciaio spazzolato, collare di cotta di maglia, una spada corta tenuta nella zampa destra" è completo. Aggiungere un mantello, un elmo, uno scudo e uno stendardo dà al modello cinque oggetti da risolvere in dieci secondi e ne perderà o fonderà alcuni.
- Una azione — un unico movimento dominante per l'intera clip. "Fa un passo avanti su un gradino di pietra" è un'inquadratura. "Fa un passo avanti, guarda in alto, poi solleva la spada" sono tre inquadrature compresse in una, e il risultato è una sbavatura.
- Camera — come si muove l'inquadratura. "Inquadratura media fissa" o "lento dolly in sulle zampe". Una istruzione di camera per prompt.
- Illuminazione — ora del giorno e direzione. "Luce bassa del crepuscolo da sinistra, bordo caldo sul margine dell'armatura" batte "illuminazione cinematografica", che non dice al modello nulla su cui possa agire.
Un prompt costruito così si legge come una shot list invece che come un desiderio. Questo è il punto: Seedance 2.0 renderizza ciò che riesce a risolvere fotogramma per fotogramma, e ogni slot che riempi riduce il numero di decisioni che deve indovinare.
Questo clip: 30 crediti · 6 clip al mese per $39.90 (Pro), oppure 80 all'anno per $319
Frammenti forti contro frammenti deboli
La differenza tra un prompt utilizzabile e una generazione sprecata è di solito una o due scelte di parole. La tabella sotto abbina frammenti che si risolvono in modo pulito con frammenti che non lo fanno.
| Slot | Frammento debole | Frammento forte | | ------------- | ------------------ | ------------------------------------------------------------- | | Soggetto | un gatto carino | soriano grigio, calzini bianchi, orecchio sinistro tagliato | | Guardaroba | armatura medievale | corazza in acciaio spazzolato, collare di cotta di maglia | | Azione | essere eroico | pianta una zampa anteriore in avanti e resta fermo | | Camera | cinematografico | inquadratura media fissa, altezza occhi | | Illuminazione | luce drammatica | luce laterale del crepuscolo da sinistra, bordo caldo | | Ambientazione | cose da castello | lastre di pietra bagnate in un cortile illuminato da lanterne | | Scala | minuscolo ed epico | alto fino al ginocchio del cavaliere in piedi dietro di lui |
Due schemi spiegano quasi ogni frammento debole. Il primo è l'astrazione: "eroico", "epico", "cinematografico" descrivono una sensazione, e il modello non ha pixel per una sensazione. Il secondo è l'espansione eccessiva dell'ambito: un singolo frammento che chiede contemporaneamente un cambio di guardaroba, un cambio di espressione e un cambio di luogo.
Nota la riga della scala. La scala ambigua è il fallimento più silenzioso in tutto questo formato, perché il gatto sembra a posto e il mondo sembra sbagliato. Di' "alto fino al ginocchio del cavaliere dietro di lui" invece di "minuscolo", e il cortile, i telai delle porte e le altre figure si risolvono tutti alla dimensione giusta. Il preset piccolo cavaliere e protettore gigante è costruito interamente su quella relazione, quindi è il modo più rapido per vedere il linguaggio della scala funzionare.
Il linguaggio di camera che cambia l'output
Le istruzioni di camera sono un vero parametro nel render, non testo decorativo. Due famiglie coprono la maggior parte di ciò che ti serve.
Inquadrature fisse mantengono l'inquadratura ferma mentre il soggetto si muove. Una inquadratura fissa è l'opzione più stabile, perché il modello deve animare solo una cosa in movimento: il tuo gatto. Pan e push significano che anche lo sfondo deve essere reinventato a ogni fotogramma, e la reinvenzione dello sfondo è dove compaiono deformazioni e scorrimento delle texture. Se un render continua a disfarsi, rimuovi il movimento di camera prima di riscrivere qualsiasi altra cosa.
Dolly e push-in spostano la camera verso o lontano dal soggetto. Un lento push-in si legge come intenzione e funziona bene per un gatto fermo, perché il movimento è portato dall'inquadratura invece che dall'animale. Mantieni il movimento unico e lento: "slow dolly in" è stabile, "dolly in poi crane up" sono due movimenti e il secondo di solito mangia il primo.
Per entrambe le famiglie, nomina l'inquadratura e l'altezza. "Inquadratura media ad altezza occhi" e "inquadratura ampia bassa dal pavimento" producono composizioni visibilmente diverse, ed entrambe sono più utili di "primo piano" da solo. Un'angolazione bassa fa leggere il gatto come più grande, il che è utile quando la battuta dipende dal fatto che l'animale venga sottovalutato. Una inquadratura media ad altezza occhi mantiene leggibile la silhouette dell'armatura, che di solito è ciò che vuoi quando il guardaroba è il punto.
Perché conta una sola azione per inquadratura
Una clip di dieci secondi ha spazio sufficiente per un movimento convincente. Quando un prompt chiede due o tre azioni separate, il modello distribuisce una quantità fissa di animazione tra loro e ognuna ne riceve meno. Il risultato visibile è una sbavatura: arti che si muovono a metà, una rotazione che non si completa mai, una spada sollevata che diventa una scia d'acciaio.
C'è una seconda ragione, e ha a che fare con la geometria nascosta. Gli arti in più compaiono quando il prompt implica una posa del corpo che la foto di riferimento non mostra. Se la tua foto è un gatto seduto e il prompt chiede "in piedi sulle zampe posteriori e che agita una spada", il modello deve inventare la pancia, le zampe posteriori estese e la posizione della zampa dal nulla, e spesso inventa un arto di troppo o mette una zampa dove dovrebbe esserci la coda. Una posa di riferimento vicina all'azione che vuoi, più un unico movimento dominante, previene la maggior parte di questo.
La regola pratica: se puoi descrivere la clip con "e poi", dividila in due generazioni. Due clip da trenta crediti ciascuna ti danno due inquadrature utilizzabili. Una clip che chiede entrambe ti dà una sbavatura che costa lo stesso e non può essere salvata rigenerando il testo.
Sei esempi di prompt
Ogni esempio sotto riempie i cinque slot e nient'altro. La formulazione è deliberatamente semplice, perché una formulazione semplice lascia meno spazio al modello per interpretare.
- Marcia nel cortile (con foto). Il gatto nel riferimento, corazza in acciaio spazzolato e collare di cotta di maglia, pianta una zampa anteriore in avanti su lastre di pietra bagnate e resta fermo, inquadratura media fissa ad altezza occhi, luce laterale del crepuscolo da sinistra con un bordo caldo sull'armatura.
- Servizio di guardia (con foto). Il gatto nel riferimento, elmo di ferro ammaccato e una spada corta tenuta in basso, resta seduto immobile mentre la pioggia cade oltre l'inquadratura, inquadratura ampia fissa dall'altezza del pavimento, luce fredda coperta con una singola lanterna a destra.
- Protettore gigante (con foto). Il gatto nel riferimento, nessuna armatura tranne un collare di cuoio, guarda in alto e sostiene lo sguardo, lento dolly in verso un'inquadratura media, controluce del crepuscolo e ombre lunghe sulla pietra.
- Porta del castello (con foto). Il gatto nel riferimento, collare di cotta di maglia e un piccolo stendardo legato sul dorso, cammina di due passi verso la porta e si ferma, inquadratura media fissa ad altezza occhi, luce di torcia da destra contro l'aria blu della sera.
- Text-to-video, gatto cavaliere accanto a un focolare. Un piccolo gatto nero con una macchia bianca sul petto, corazza d'acciaio e collare di cotta di maglia, si rannicchia più stretto attorno a una ciotola e si acquieta, inquadratura ravvicinata fissa a livello del pavimento, luce calda del fuoco da sinistra con ombra profonda dietro.
- Text-to-video, veglia notturna. Un soriano rosso tarchiato, piastra d'acciaio lucida e una spada corta appoggiata a terra, solleva la testa una volta e la tiene, lento dolly in da un'inquadratura ampia, freddo chiaro di luna attraverso una finestra stretta con riempimento di lanterna a destra.
I numeri da 1 a 4 presuppongono una foto di riferimento, quindi lo slot del soggetto si riduce a una singola frase e il modello fa l'ancoraggio dell'identità dall'immagine. I numeri 5 e 6 portano la descrizione del mantello perché non c'è una foto che la fissi.
Errori comuni
Due azioni in una inquadratura. Trattato sopra, e ancora la causa singola più comune di una sbavatura. Dividi la clip.
Guardaroba vago. "Armatura" non è un guardaroba. Nomina il materiale e il pezzo. "Corazza in acciaio spazzolato" e "elmo di ferro ammaccato" si risolvono in pixel diversi, e il modello non sceglierà per te.
Scala ambigua. "Minuscolo" ed "epico" descrivono ciò che provi per il gatto, non la sua dimensione nella scena. Fornisci un confronto: "alto fino al ginocchio del cavaliere dietro di lui", "più piccolo dello scudo appoggiato al muro".
Accumulo di aggettivi. Quattro aggettivi davanti a un sostantivo dividono l'attenzione del modello tra tutti e quattro. Scegli quello che conta e spendi le parole rimanenti sull'azione.
Cambiare la camera a metà prompt. Una istruzione di camera per generazione. Un prompt che chiede contemporaneamente inquadratura fissa e dolly non produce né l'una né l'altra.
Se vuoi la versione più breve a checklist di questo materiale, la guida come creare un video AI di gatti cavalieri copre il flusso di caricamento e preset attorno a questi prompt, e la pagina iniziale mostra i quattro preset che la maggior parte dei prompt finisce per descrivere.
Costo del prompt e iterazione
Scrivere il prompt costa poco rispetto al rendering, ed è per questo che iterare sul testo è la prima mossa giusta. La specifica di consegna predefinita è Standard 1080p a dodici secondi per trenta crediti, e l'opzione Standard 720p da dodici secondi sulle schede dei prezzi è dieci crediti. I render 480p da dodici secondi costano cinque crediti, e le clip più lunghe scalano linearmente e arrotondano per eccesso.
Questo conta per una ragione semplice: se un render fallisce, i crediti vengono rimborsati, ma un render che riesce e sembra sbagliato no. Cinque crediti a 480p sono il modo più economico per testare se un'azione si legge prima di impegnarti in una ripresa 1080p. Scrivi il prompt, renderizzalo alla risoluzione più bassa che mostra ancora il movimento, e solo allora spendi il livello superiore. Puoi vedere i livelli attuali sulla pagina dei prezzi.
I nuovi account ricevono trenta crediti una volta tramite l'accesso con Google. La registrazione via email parte da zero finché non viene riscattato il check-in giornaliero, che concede dieci, poi venti, poi trenta, poi dieci al giorno per altre quattro volte. I render restano privati nel tuo account, nulla viene pubblicato su un feed pubblico e nessun render porta una filigrana.
FAQ
Quanto deve essere lungo un prompt? Due a quattro frasi bastano. Cinque slot, una clausola ciascuno. Prompt più lunghi dividono l'attenzione tra più oggetti e di solito producono un risultato più debole, non più ricco.
Il prompt sovrascrive la mia foto di riferimento? No, e non dovrebbe provarci. La foto fissa l'identità e il prompt descrive la scena attorno a essa. Se vuoi un gatto diverso, carica una foto diversa invece di descrivere un mantello diverso nel testo.
Perché il mio gatto sviluppa arti in più? Il prompt chiede una posa del corpo che la foto non mostra. Abbina la posa di riferimento all'azione, mantieni un solo movimento dominante, e il modello smette di indovinare la geometria nascosta.
Devo scrivere il mio prompt come parole chiave o frasi? Frasi con slot chiari. Gli elenchi di parole chiave funzionano come ripiego, ma le frasi portano le relazioni tra soggetto, azione e camera, e sono quelle relazioni che il modello anima.
Quale impostazione di camera dovrei usare per prima? Inquadratura fissa. È l'opzione più stabile, e una volta che quella renderizza in modo pulito puoi aggiungere un lento dolly in come unica modifica.
Posso riutilizzare un solo prompt per tutti e quattro i preset? No. I preset landa spazzata dalla tempesta, piccolo gatto con un cavaliere gigante, porta del castello al crepuscolo e guardiano del latte impostano ciascuno l'ambientazione e la scala, quindi il tuo prompt dovrebbe fornire guardaroba, azione, camera e illuminazione oltre a quello, invece di ripetere la scena.