고양이를 기사로 변신: 사진 한 장이 좋은 결과를 만드는 조명, 눈, 구도, 배경의 역할
 Knight Cat AI Team
사진 한 장으로 고양이를 기사로 변신시키세요: 조명, 눈이 잘 보이는지, 구도, 배경 분리가 렌더에서 반려동물을 알아볼 수 있게 유지하는지를 결정합니다.
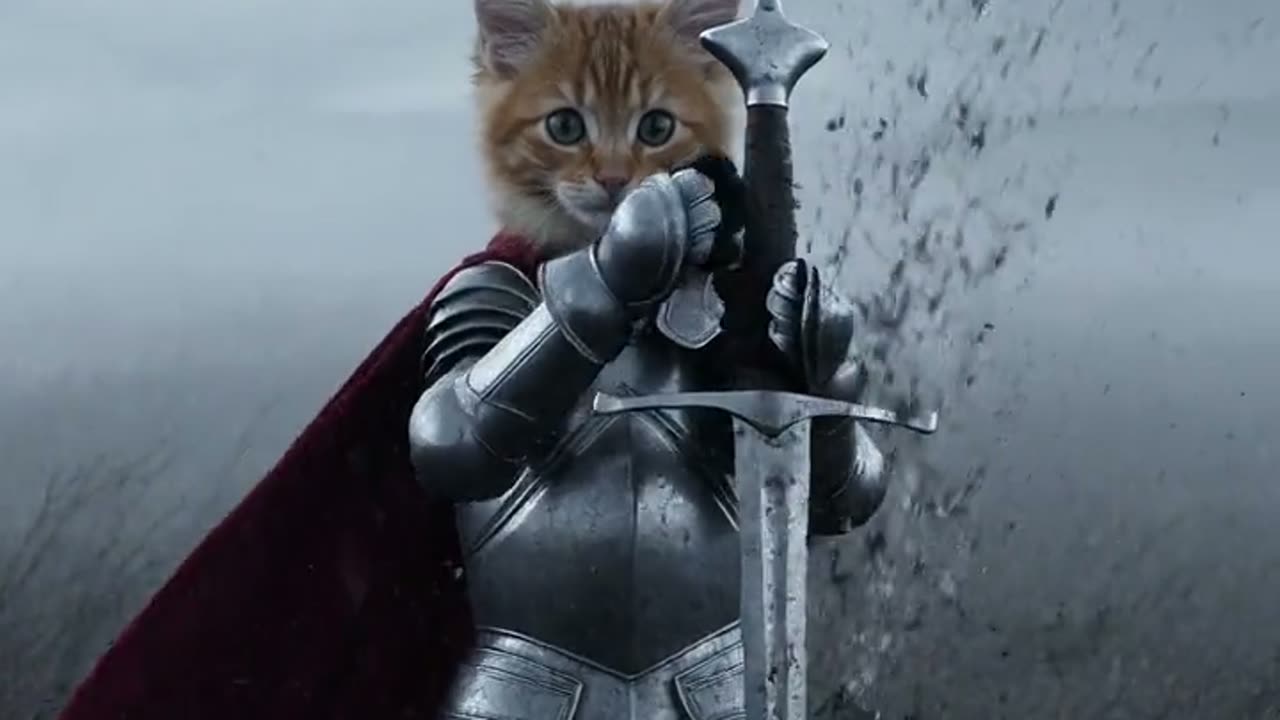
당신은 스튜디오에 사진 한 장을 업로드하고, 네 가지 중세 프리셋 중 하나를 선택한 뒤, Seedance 2.0 모델이 같은 반려동물이 갑옷을 입은 약 10초짜리 세로 클립을 렌더링하도록 하여 고양이를 기사로 만듭니다. 사진은 그 파이프라인에서 당신이 정확히 통제할 수 있는 유일한 부분이며, 결과의 대부분을 결정합니다. 모델이 사진을 스타일 제안이 아니라 정체성 참조로 사용하기 때문입니다. 고르고 부드러운 빛, 두 눈이 보이고, 피사체가 하나이며, 배경이 털과 깔끔하게 분리되는 사진은 의상 변화를 거쳐도 고양이의 무늬와 얼굴형을 유지합니다. 급하게 찍은 휴대폰 스냅샷은 보통 그렇지 않습니다.
참조 사진이 실제로 통제하는 것
업로드는 두 가지 별개의 역할을 하며, 이 둘을 혼동하는 것이 대부분의 실망스러운 렌더의 원인입니다.
첫 번째 역할은 정체성 고정입니다. 모델은 사진을 읽고 피사체의 털 무늬, 얼굴형, 눈 색, 귀 위치와 무늬를 고정합니다. 그러한 속성은 제약이 되므로, 프리셋은 동물 자체는 알아볼 수 있게 유지하면서 갑옷, 배경, 빛을 자유롭게 바꿀 수 있습니다. 사람들이 결과물이 "내 고양이가 아니라 일반적인 기사 고양이처럼 보인다"고 말할 때, 약한 고정이 거의 항상 이유입니다.
두 번째 역할은 형태 정보 제공입니다. 모델은 볼 수 있는 신체 형태만 압니다. 사진이 앉아 있는 고양이를 보여 주는데 프리셋이나 추가 텍스트가 서 있는 자세를 암시하면, 모델은 다리, 배, 아랫면에 대한 이미지 근거가 없으므로 추측합니다. 추측은 여분의 발과 복제된 꼬리가 생기는 지점입니다.
아래의 모든 내용은 이 두 역할에서 이어집니다. 조명과 선명도는 고정에 기여합니다. 자세와 구도는 형태 정보에 기여합니다. 배경과 피사체 수는 둘 다에 영향을 줍니다.
현재 가장 좋아하는 사진으로 한 번, 의도적으로 준비한 사진으로 한 번 렌더를 실행하면 그 효과를 즉시 확인할 수 있습니다. 스튜디오는 이 페이지에 있습니다.
이 클립: 30크레딧 · 월 6편 $39.90(Pro), 또는 연 80편 $319
조명: 첫 번째 필터
모델은 극적인 빛이 필요하지 않습니다. 형태를 설명하면서 형태를 가리지 않는 빛이 필요합니다.
창문에서 들어오는 부드럽고 방향성 있는 자연광이 얼굴을 적당한 각도로 비추면 거의 이상적입니다. 이는 털 질감에 보이는 윤곽을 주고 눈을 읽을 수 있게 유지합니다. 흐린 야외 빛도 비슷하게 작동하며 종종 찾기 더 쉽습니다.
강한 직사광선은 한 번에 두 가지 문제를 만듭니다. 밝은 하이라이트가 밝은 털에서 평평한 흰색으로 잘리고, 얼굴의 그림자 쪽은 보이는 무늬 없이 어두운 덩어리로 무너집니다. 둘 다 모델이 고정할 수 있는 정보를 줄입니다. 동물을 향해 정면으로 터진 플래시도 더 작은 규모로 같은 일을 합니다. 얼굴을 평평하게 만들고, 주둥이를 정의하는 그림자를 없애며, 눈에 밝은 반사를 만들어 동공 모양을 가릴 수 있습니다.
역광은 피해야 할 세 번째 경우입니다. 밝은 창문 앞에 앉은 고양이는 실루엣이 되고, 실루엣은 거의 정체성 정보를 담지 않으므로, 모델은 당신의 고양이를 전사하는 대신 그럴듯한 고양이를 만들어 내야 합니다.
유일하게 좋은 사진이 어둡다면, 얼굴 절반이 날아간 밝은 사진보다 약간 노이즈가 있지만 고르게 조명된 사진을 선호하세요. 노이즈는 세부 정보가 빠진 것보다 작은 문제입니다.
눈 보임과 얼굴 가독성
두 눈이 보이고, 뜨고, 초점이 맞는 것이 참조 사진이 가질 수 있는 단일 최고 가치 속성입니다. 얼굴은 정체성을 판단하는 곳이고, 눈은 보는 사람이 그것을 확인하는 곳입니다.
세 가지 상황이 이를 깨뜨립니다:
- 머리 각도 때문에 한쪽 눈이 가려져 모델이 가려진 눈을 합성해야 합니다. 결과는 종종 비대칭이거나 약간 잘못되어, 다른 것이 모두 맞아도 불쾌한 느낌을 줍니다.
- 눈을 가늘게 뜨거나 감은 상태는 정체성을 고정하는 눈 색과 눈 모양 신호를 제거합니다.
- 얼굴의 모션 블러나 초점 실패는 모델이 정확히 고정할 것을 남기지 않습니다.
서 있는 높이에서 내려다보지 말고 카메라를 동물의 눈높이에 맞추세요. 그 한 가지 변화가 대부분의 실내 촬영에서 각도 문제를 해결하고 세로 프레임에서 머리가 보이는 방식도 개선합니다.
고양이가 가만히 있지 않는다면 연사로 찍고, 자세가 덜 예뻐 보여도 동공이 가장 선명한 프레임을 고르세요. 얼굴의 선명도는 항상 더 나은 몸 각도보다 낫습니다.
피사체 하나를 프레임에 담기
프레임에 두 번째 동물이나 사람이 있는 것은 잘못된 대상이 갑옷을 입거나, 모델이 주의를 나누어 두 피사체 모두 반만 렌더되는 가장 흔한 원인입니다.
다른 반려동물을 제거하고, 사람을 제거하고, 두 번째 살아 있는 피사체로 읽히는 모든 것을 제거하세요. 이것은 미적 선호만이 아닙니다. 모델은 피사체가 무엇인지 결정해야 하며, 동물 두 마리가 있는 프레임은 두 가지 후보 답을 줍니다. 때로는 잘못된 쪽으로 확정하고, 때로는 둘의 특징을 섞습니다.
장난감과 물건은 보통 무해하지만, 가슴에 눌린 쿠션이나 다리 위의 담요처럼 동물의 몸과 겹치는 큰 물체는 나중에 필요할 수 있는 형태 정보를 사실상 숨깁니다. 합리적으로 가능한 한 동물 자체의 실루엣을 가리지 마세요.
머리와 어깨 대 전신
두 크롭 모두 작동하며 서로 다른 일을 합니다.
머리와 어깨 크롭은 세부 정보를 얼굴에 집중시킵니다. 동물이 더 많은 픽셀을 차지해 고정을 강화하고, 모델이 해석할 몸이 더 적습니다. 초상화 같은 처리, 느린 푸시인, 또는 고양이가 자리 잡고 주변 움직임만 일어나는 파수꾼 자세를 요구하는 프리셋과 프롬프트에 적합합니다.
전신 크롭은 더 많은 형태 정보를 제공합니다. 다리가 얼마나 긴지, 꼬리가 어디에 있는지, 몸이 무게를 어떻게 싣는지 모델에 알려 주어 걷기와 발걸음 샷을 더 안정적으로 만듭니다. 대가로 얼굴이 더 적은 픽셀을 차지하므로 정체성 고정이 약간 약해집니다.
| 크롭 | 강화하는 것 | 가장 적합한 용도 | | ----------- | ------------------------------------ | ---------------------------------------------- | | 머리와 어깨 | 얼굴 세부 정보, 눈 가독성, 무늬 전사 | 초상화 프레이밍, 고정 샷, 주변 움직임 | | 전신 | 다리와 꼬리 형태, 비율, 자세 | 걷기, 발걸음, 반려동물 전체가 움직이는 모든 샷 | | 미드 샷 | 둘의 사용 가능한 균형 | 사진이 한 장뿐일 때 안전한 기본값 |
사진이 한 장뿐이고 어떤 프리셋을 원할지 확실하지 않다면, 머리가 선명하게 나오고 몸통 대부분을 포함하는 미드 샷이 가장 관대한 선택입니다. 선택할 수 있다면 두 가지 모두 준비하고 초상화에는 머리와 어깨 버전을, 움직임에는 전신 버전을 사용하세요.
배경 분리
모델은 고양이가 어디에서 끝나는지 알아야 합니다. 고양이처럼 보이는 배경은 그것을 더 어렵게 만듭니다.
단순한 벽, 바닥, 부드럽게 초점이 흐려진 실내는 잘 분리됩니다. 어지러운 선반, 무늬 있는 러그, 털과 비슷한 색조의 프린트 직물은 그렇지 않습니다. 실패 유형은 가장자리에서 털이 배경으로 녹아들어 모델이 어떤 픽셀이 동물인지 더 이상 구분하지 못하고, 만들어 내는 실루엣이 엉성해지는 것입니다.
심도는 도움이 되지만 밝은 렌즈가 필요하지는 않습니다. 동물을 벽에서 1미터 떨어뜨리고 낮은 각도에서 촬영하면, 단순히 벽이 더 멀고 더 부드러워지기 때문에 카메라의 어떤 설정보다 더 나은 분리를 만들어 내는 경우가 많습니다.
사진 권장 및 비권장 표
| 이렇게 하세요 | 이것을 피하세요 | 방지하는 실패 | | ----------------------------------- | -------------------------------- | ------------------------------------------------- | | 얼굴을 가로지르는 부드러운 창문 빛 | 직사광선 또는 정면 플래시 | 하이라이트 날아감, 얼굴 세부 정보 손실, 약한 고정 | | 두 눈이 뜨고 선명하며 눈높이에 맞춤 | 머리가 돌아가 한쪽 눈이 가려짐 | 합성 눈, 비대칭 얼굴, 불쾌한 결과 | | 프레임에 동물 한 마리 | 두 번째 반려동물 또는 사람 | 잘못된 피사체에 갑옷 입힘 또는 특징 혼합 | | 단순하거나 부드럽게 흐린 배경 | 털과 색조가 가까운 어지러운 무늬 | 털 가장자리 녹아듦, 거친 실루엣 | | 원하는 동작과 일치하는 자세 | 사진이 보여 준 적 없는 자세 요청 | 여분의 팔다리, 복제된 발, 엉뚱한 꼬리 | | 미드 또는 머리와 어깨 크롭 | 반려동물이 작게 나오는 와이드 샷 | 약한 정체성 고정, 일반적으로 보이는 고양이 |
정체성 고정이 털 무늬와 얼굴형을 전사하는 방식
고정은 스타일 전사가 아닙니다. 모델은 사진 위에 갑옷을 칠하는 것이 아닙니다. 참조 이미지에 피사체를 조건화하면서 새 프레임을 생성하는 것이며, 그래서 전사가 그런 방식으로 작동합니다.
털 무늬 전사는 가장 눈에 띄는 부분입니다. 태비 줄무늬, 턱시도 블록, 토티셸 패치, 얼굴 흰 줄무늬의 특정 비대칭성은 모두 모델이 고정할 수 있는 고대비의 반복 가능한 특징이므로 의상 변화를 견딥니다. 참조에서 무늬가 더 많이 보일수록 결과물에도 더 많이 나타납니다. 태비의 머리만 보여 주는 사진은 머리 줄무늬는 전사하지만 몸통 무늬에 대한 근거를 모델에 주지 않으므로 몸통 무늬는 정확하기보다 그럴듯합니다.
얼굴형 전사는 더 미묘하고 인식에 더 중요합니다. 귀 위치, 주둥이 길이, 눈썹의 곡선, 광대뼈 너비는 한 고양이를 다른 고양이와 한눈에 구별되게 하는 요소입니다. 이것들은 가까운 거리와 고른 빛에서 가장 잘 읽히며, 그래서 머리와 어깨 크롭은 단순한 편의가 아니라 고정 전략입니다.
두 가지가 둘 다를 침식합니다. 거리입니다. 넓은 프레이밍에서는 얼굴이 형태를 추출하기에 픽셀이 너무 적습니다. 그리고 압축입니다. 심한 JPEG 아티팩트는 무늬를 담고 있는 바로 그 미세한 털 디테일을 손상시킵니다.
개도 같은 방식으로 작동합니다
이 파이프라인은 고양이 전용이 아닙니다. 개 사진 한 장을 업로드하면 같은 네 가지 프리셋이 그 개를 작은 갑옷 기사로 렌더링하며, 털색, 무늬, 얼굴형에 같은 정체성 고정을 사용합니다.
사진 요구 사항은 변경 없이 그대로 적용됩니다. 고른 빛, 두 눈이 보임, 피사체 하나, 깨끗한 배경 분리, 그리고 의도한 움직임과 일치하는 자세입니다. 개는 형태 단계에서 종종 더 쉽습니다. 서 있는 개 사진은 몸을 둥글게 말고 자는 고양이 사진이 제공하지 않는 다리 위치를 제공하기 때문입니다. 하지만 흐리거나 조명이 나쁜 개 사진은 나쁜 고양이 사진과 같은 방식으로 실패합니다.
가치 있는 한 가지 조정은 프레이밍입니다. 주둥이가 긴 품종은 주둥이를 읽을 수 있게 유지하려면 머리가 프레임에서 약간 더 크게 나와야 하고, 어두운 털의 개 눈은 밝은 고양이보다 더 밝고 더 정면인 광원에서 이점을 얻습니다.
좋은 사진에서 완성된 클립까지
- 위 표를 사용해 사진을 고르세요. 여러 장이 있다면 눈이 가장 선명하고 배경이 가장 깨끗한 것을 고르세요.
- 프리셋을 고르세요. 장면, 의상, 카메라 움직임은 프리셋에서 나옵니다.
castle_gate와milk_guardian은 첫 시도에 가장 관대합니다. 둘 다 안정적인 자세와 작은 주변 움직임을 요구하기 때문입니다. - 샷을 하나의 동작으로 유지하세요. 하나의 지배적인 움직임은 깨끗하게 렌더됩니다. 두세 개의 겹친 동작은 번지거나 빠집니다.
- 해상도를 선택하세요. 기본 제공 사양은 Standard · 1080p · 12s이며 30 크레딧입니다. Standard 720p 12초 렌더는 10 크레딧이고, 480p 12초는 5 크레딧입니다. 현재 요금제는 가격 페이지에 나와 있습니다.
- 렌더하고 다운로드하세요. 결과물은 계정에 비공개로 제공되고, 워터마크가 없으며, MP4로 도착합니다. 실패한 렌더는 원래 차감된 잔액으로 환불됩니다.
전체 파이프라인이 처음부터 끝까지 설명되길 원한다면, 텍스트-투-비디오가 어떻게 다른지 포함해 비디오 생성기 개요부터 시작하세요. 이미 신뢰하는 사진이 있고 여러 샷의 연속을 계획하고 싶다면 단계별 안내에서 샷을 연결하는 방법을 다룹니다. 그리고 반려동물이 거대한 갑옷 인물 옆에 작게 서 있는 프레이밍을 좋아한다면 작은 기사와 거대한 수호자 분석에서 두 번째 큰 인물이 모델이 일관되게 유지해야 하는 요소를 어떻게 바꾸는지 설명합니다.
자주 묻는 질문
사진 없이 고양이를 기사로 만들 수 있나요?
네. 텍스트-투-비디오는 설명만으로 작동하지만, 털 무늬와 얼굴형을 고정할 참조 이미지가 없기 때문에 당신의 특정 반려동물이 아니라 일반적인 갑옷 고양이를 만듭니다. 결과를 알아볼 수 있게 당신의 것으로 만드는 것은 사진 방식입니다.
사진에서 단일 가장 중요한 것은 무엇인가요?
두 눈이 보이고 선명한 것입니다. 얼굴은 정체성을 판단하는 곳이고, 눈은 보는 사람이 동물이 맞는지 가장 빠르게 확인하는 방법입니다.
업로드 전에 사진을 크롭해야 하나요?
크롭은 괜찮고 종종 도움이 됩니다. 단, 머리 전체를 프레임에 유지하고 주변에 약간의 공간을 남겨야 합니다. 귀가 가장자리에 닿을 정도로 너무 꽉 크롭하지 말고, 작은 크롭을 업스케일하지 마세요. 보간이 무늬를 고정하는 미세한 털 디테일을 제거하기 때문입니다.
왜 우리 고양이는 여분의 발을 가지고 나왔나요?
프롬프트가 사진에 나오지 않은 신체 자세를 암시했기 때문에 모델이 숨겨진 형태를 만들어 냈습니다. 원하는 자세와 일치하는 참조 사진을 사용하고 샷을 하나의 동작으로 줄이세요.
대신 개 사진을 업로드할 수 있나요?
네. 개는 같은 프리셋을 통해 같은 사진 요구 사항으로 작은 갑옷 기사로 렌더링됩니다.
렌더 비용은 얼마인가요?
기본 제공 사양은 Standard · 1080p · 12s이며 30 크레딧입니다. 가격 카드에 표시된 Standard 720p 12초 렌더는 10 크레딧이고, 480p 12초는 5 크레딧입니다. 더 긴 클립은 선형으로 확장되고 올림됩니다. Google 로그인을 통한 새 계정은 30 크레딧으로 한 번 시작하며, 이는 1080p 렌더 한 번을 정확히 커버합니다. 반면 이메일 가입은 매일 체크인을 통해 잔액을 쌓습니다.
어디서 시작하나요?
메인 페이지를 열고, 로그인하고, 가장 선명하고 조명이 가장 좋은 사진을 업로드한 뒤, 1080p 기본값에 30 크레딧을 쓰기 전에 정체성 고정이 유지되는지 확인하기 위해 480p 렌더를 실행하세요.