Knight Cat AI 视频提示词:一套行之有效的结构,先写主体服装动作镜头灯光,再补形容词让每镜更稳定
 Knight Cat AI Team
Knight Cat AI 视频提示词需要五个按顺序排列的槽位:主体、服装、一个动作、镜头和灯光。先写结构,后写形容词,每条提示词只对应一个镜头。
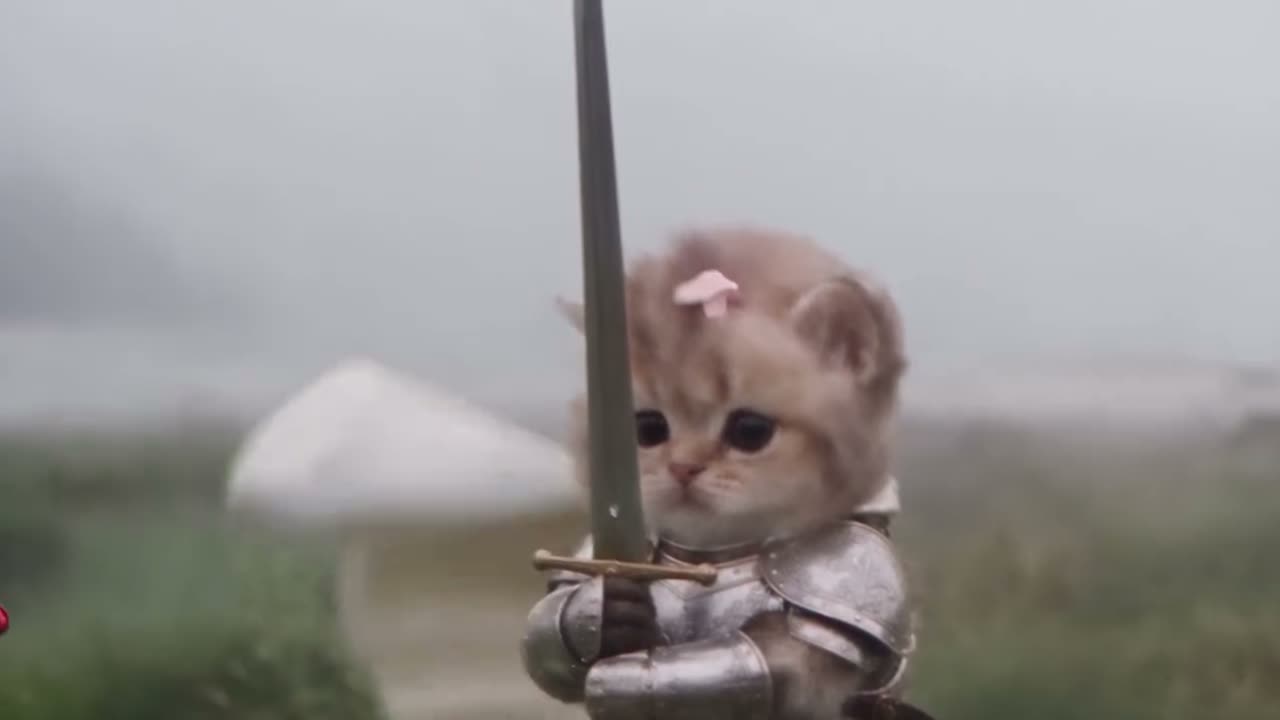
一个好的 Knight Cat AI 视频提示词会按固定顺序填满五个槽位:主体、服装、一个动作、镜头、灯光。你可能想额外添加的其他内容都是装饰,而装饰正是让一段 10 秒渲染糊掉的部分。本指南涵盖工作室支持的两种提示词路径、经得起使用的片段模式、真正会改变输出的镜头词汇,以及导致大多数糟糕渲染的三种失败模式。
两种提示词路径
工作室接受参考照片或文字描述,而你写下的提示词会根据你提供的是哪一种而表现不同。
如果你上传照片,文字提示词不需要描述猫。照片已经通过身份锚定固定了毛色图案、脸型、耳朵位置和斑纹,这正是让模型更换服装和场景时仍能让你的宠物保持可辨识的机制。你的文字应该描述猫被放入的场景:它穿什么、做什么、镜头在哪里,以及光如何落下。
如果你不提供照片,提示词也必须承载主体。这意味着要写明品种轮廓、毛色和图案,以及你希望模型从哪个身体姿态开始。文生视频更灵活,因为没有任何东西约束构图;也更少容错,因为同样没有任何东西锚定身份。没有照片也没有毛色描述的提示词会生成一只泛泛的装甲猫,和你的宠物只有物种上的相似。
如果你想在动笔之前并排看到两种输入,就从 Knight Cat AI 视频生成器 开始。
五槽位提示词结构
按这个顺序把你的提示词写成五个短语。顺序的重要性不如每个槽位只填一次的纪律。
- 主体 — 屏幕上是谁。有参考照片时,这就是一个短语,比如“参考照片里的猫”。没有照片时,给出毛色、图案和体型:“一只小灰虎斑猫,白袜,左耳有缺口”。
- 服装 — 一层盔甲和一件携带物品,仅此而已。“拉丝钢胸甲、锁子甲项圈、右爪握一把短剑”就算完整。再加披风、头盔、盾牌和旗帜,就是给模型五个要在 10 秒内解析的物体,它会丢掉或合并其中一些。
- 一个动作 — 整段片段只有一个主导运动。“向前迈上石阶”是一个镜头。“向前迈步、抬头,然后举剑”是三个镜头压缩成一个,结果就是糊掉。
- 镜头 — 画面如何运动。“固定中景”或“缓慢推近到爪子”。每个提示词只写一条镜头指令。
- 灯光 — 一天中的时间和方向。“左侧低角度黄昏光,盔甲边缘有暖色轮廓光”胜过“电影感灯光”,后者没有告诉模型任何可执行的信息。
这样构建的提示词读起来像镜头清单,而不是愿望。这就是重点:Seedance 2.0 会逐帧渲染它能解析的内容,而你填的每个槽位都会减少它必须猜测的决定数量。
本条视频:30 积分 · 每月 6 条为 $39.90(Pro),或每年 80 条为 $319
强片段与弱片段对比
一个可用提示词和一次浪费的生成之间的差别,通常只是一两个词的选择。下表把能干净解析的片段与不能的片段配对。
| Slot | Weak fragment | Strong fragment | | -------- | -------------- | -------------------------------------------- | | Subject | a cute cat | grey tabby, white socks, clipped left ear | | Wardrobe | medieval armor | brushed steel chestplate, chainmail collar | | Action | being heroic | plants one front paw forward and holds still | | Camera | cinematic | locked-off medium shot, eye level | | Lighting | dramatic light | dusk side light from the left, warm rim | | Setting | castle stuff | wet flagstones in a lantern-lit courtyard | | Scale | tiny and epic | knee-high to the knight standing behind it |
两种模式解释了几乎所有弱片段。第一种是抽象:“英勇”“史诗”“电影感”描述的是感觉,而模型没有对应感觉的像素。第二种是范围蔓延:单个片段同时要求更换服装、改变表情和改变地点。
注意比例那一行。模糊的比例是整个格式里最安静的一种失败,因为猫看起来没问题,而世界看起来不对。说“到站在它身后的骑士膝盖高”,而不是“微小”,庭院、门框和其他人物就都会解析成正确大小。微型骑士与巨型保护者 预设完全围绕这种关系构建,所以它是看到比例语言生效的最快方式。
真正改变输出的镜头语言
镜头指令是渲染中的真实参数,不是点缀文字。两大类覆盖你所需的大部分内容。
固定机位镜头让画面保持静止,而主体移动。固定机位是最稳定的选项,因为模型只需要动画化一个会动的东西:你的猫。摇镜和推镜意味着背景也必须在每一帧被重新发明,而背景重新发明正是变形和纹理蠕动出现的地方。如果一次渲染不断崩坏,先移除镜头运动,再改写其他任何内容。
推拉镜头和推近让摄影机朝主体靠近或远离。缓慢推近会读作意图,而且很适合站定不动的猫,因为运动由画面而不是动物承载。让运动保持单一且缓慢:“缓慢推近”是稳定的,“推近然后升镜”是两个运动,第二个通常会吃掉第一个。
对于这两类,都要写明取景和高度。“平视中景”和“从地面拍摄的低角度全景”会产生明显不同的构图,而且两者都比单独的“特写”更有用。低角度会让猫显得更大,当笑点依赖于动物被低估时很有用。平视中景则让盔甲轮廓保持清晰可辨,当服装是重点时,这通常正是你想要的。
为什么每个镜头只做一个动作很重要
一段 10 秒片段只够容纳一个可信的运动。当提示词要求两三个分开的动作时,模型会把固定量的动画分配给它,每个动作得到的就更少。可见结果就是糊掉:四肢只动到一半、转身永远转不完、举起的剑变成一团钢铁模糊。
还有第二个原因,和隐藏几何有关。当提示词暗示参考照片没有展示的身体姿态时,多余肢体就会出现。如果你的照片是一只坐着的猫,而提示词要求“后腿站立并挥剑”,模型就必须从无到有地发明腹部、伸出的后腿和爪子位置,而且它常常多发明一条肢体,或者把腿放在尾巴该在的地方。让参考姿态接近你想要的动作,再加上一个主导运动,就能防止大部分这类问题。
实用规则:如果你能用“然后”描述这段片段,就把它拆成两次生成。两段各 30 积分的片段会给你两个可用镜头。一段同时要求两者的片段只会给你一团糊,成本相同,而且无法通过重掷文字来挽救。
六个示例提示词
下面每个示例只填满五个槽位,仅此而已。措辞刻意平实,因为平实的措辞给模型留下的解释空间更少。
- 庭院行进(带照片)。 参考照片里的猫,拉丝钢胸甲和锁子甲项圈,一只前爪向前定在湿漉漉的石板上并保持不动,平视固定中景,左侧黄昏侧光,盔甲上有暖色轮廓光。
- 守卫任务(带照片)。 参考照片里的猫,凹陷的铁头盔和低垂握持的短剑,在雨从画面外落下时静坐不动,地面高度固定全景,冷色阴天光,右侧有一盏灯笼。
- 巨型保护者(带照片)。 参考照片里的猫,除皮质项圈外没有盔甲,抬头并保持凝视,缓慢推近到中景,黄昏逆光,石地上有长长的影子。
- 城堡大门(带照片)。 参考照片里的猫,锁子甲项圈,背后绑着一面小旗帜,朝大门走两步后停下,平视固定中景,右侧火把光映着蓝色夜空。
- 文生视频,炉边的骑士猫。 一只胸口有白斑的小黑猫,钢制胸甲和锁子甲项圈,在碗边蜷得更紧并安定下来,地面高度固定特写,左侧温暖炉火光,身后有深重阴影。
- 文生视频,夜间守望。 一只敦实的姜黄色虎斑猫,抛光钢板甲和一把支在地上的短剑,抬头一次并保持不动,从全景缓慢推近,冷色月光从窄窗照入,右侧有灯笼补光。
第 1 到第 4 个示例假定有参考照片,所以主体槽位压缩成一个短语,模型从图像进行身份锚定。第 5 和第 6 个示例带有毛色描述,因为没有照片来固定它。
常见错误
一个镜头里有两个动作。 上文已经讲过,但它仍然是糊掉最常见的原因。把片段拆开。
模糊的服装。 “盔甲”不是服装。写明材质和部件。“拉丝钢胸甲”和“凹陷的铁头盔”会解析成不同的像素,模型不会替你选择。
模糊的比例。 “微小”和“史诗”描述的是你对猫的感觉,而不是它在场景中的大小。给出比较:“到站在它身后的骑士膝盖高”“比靠在墙上的盾牌还小”。
形容词堆叠。 一个名词前面放四个形容词,会把模型的注意力分散到四个词上。挑出最重要的那个,把剩下的词用在动作上。
在提示词中途改变镜头。 每次生成只写一条镜头指令。同时要求固定机位和推镜的提示词,两者都得不到。
如果你想要这份材料的简短清单版,如何制作 Knight Cat AI 视频 演练涵盖了围绕这些提示词的上传和预设流程,而首页 展示了大多数提示词最终会描述到的四个预设。
提示词成本与迭代
相对于渲染,写提示词很便宜,所以先迭代文字是正确的第一步。默认交付规格是 Standard · 1080p · 12s,30 积分,而定价卡片上的 Standard · 720p · 12s 选项是 10 积分。480p 12s 渲染花费 5 积分,更长的片段按线性比例增加并向上取整。
这很重要,原因很简单:如果渲染失败,积分会退还,但一次成功却看起来不对的渲染不会。480p 的 5 积分是测试一个动作是否成立的最便宜方式,然后再投入 1080p 的一条。写好提示词,用仍能显示运动的最低分辨率渲染它,然后才花更高的档位。你可以在定价页 查看当前档位。
新账户通过 Google 登录一次可获得 30 积分。邮箱注册从零开始,直到领取每日签到奖励,签到会依次发放 10、20、30,然后每天 10,再重复四次。渲染会保持仅你的账户可见,不会发布到公共信息流,也没有任何渲染带有水印。
常见问题
提示词应该多长? 两到四句话就够了。五个槽位,每个一个短句。更长的提示词会把注意力分散到更多物体上,通常产生更软的结果,而不是更丰富的结果。
提示词会覆盖我的参考照片吗? 不会,也不应该试图覆盖。照片固定身份,提示词描述它周围的场景。如果你想要不同的猫,上传不同的照片,而不是在文字里描述不同的毛色。
为什么我的猫会长出多余肢体? 提示词要求的身体姿态是照片没有展示的。让参考姿态匹配动作,保持一个主导运动,模型就不会再猜隐藏几何。
我应该把提示词写成关键词还是句子? 写成槽位清晰的句子。关键词列表可以作为退而求其次的方式,但句子承载主体、动作和镜头之间的关系,而这些关系才是模型动画化的内容。
我应该先使用哪种镜头设置? 固定机位。它是最稳定的选项,一旦它能干净渲染,你就可以把缓慢推近作为唯一改动加进去。
我可以把同一个提示词用于全部四个预设吗? 不行。风暴肆虐的荒原、带巨型骑士的小猫、黄昏城堡大门和牛奶守护者这四个预设各自设定场景和比例,所以你的提示词应该在此基础上提供服装、动作、镜头和灯光,而不是重述场景。